TL;DRLa couche présentation du modèle OSI s'assure que les données envoyées par une machine soient comprises par une autre : bons caractères, bon format, taille réduite, contenu protégé. Voici son rôle, l'origine des fameux « é », le fonctionnement de gzip et Brotli, et la place, discutée, du chiffrement TLS.
La couche 6 en une phrase#
La couche 6 (layer 6) du modèle OSI, appelée couche présentation, s'occupe de la forme des données plutôt que de leur trajet. Elle répond à une question simple : comment faire pour que le texte, les nombres et les images envoyés par une machine soient compris de la même façon par une autre machine, qui n'utilise peut-être ni le même système, ni le même logiciel ?
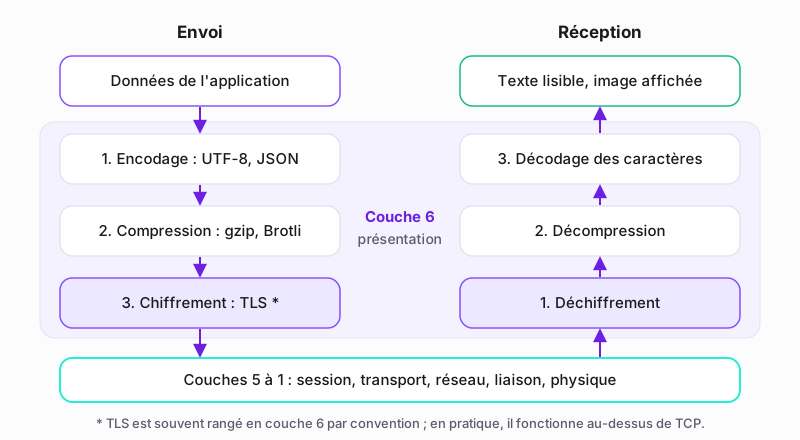
Pour y parvenir, on lui attribue trois familles de tâches : traduire les données dans une représentation commune (l'encodage), les réduire pour qu'elles voyagent plus vite (la compression) et, dans beaucoup d'explications, les protéger (le chiffrement). À l'arrivée, les mêmes opérations sont défaites dans l'ordre inverse.
Les couches précédentes ont transporté des bits sur un câble (couche 1), des trames dans un réseau local (couche 2), des paquets d'un réseau à l'autre (couche 3), des flux fiables entre deux programmes (couche 4) et organisé le dialogue (couche 5). La couche 6 est la première qui se préoccupe du sens des octets transportés.
Ce que dit la norme : une représentation commune#
Dans le texte de référence du modèle OSI (ISO/IEC 7498-1, publié aussi par l'UIT sous le nom X.200), la couche présentation garantit que les informations échangées gardent leur signification, quelle que soit la façon dont chaque machine les stocke en interne. La norme distingue deux notions :
- La syntaxe abstraite : la description des données, indépendante de toute machine. Par exemple : « une facture contient un numéro entier, une date et une liste de lignes ».
- La syntaxe de transfert : la façon concrète de transformer ces données en une suite d'octets pour le voyage. Les deux machines doivent se mettre d'accord sur cette syntaxe avant d'échanger.
Le langage historique de cette approche s'appelle ASN.1 (pour décrire la syntaxe abstraite), associé à des règles d'encodage comme BER (pour la syntaxe de transfert). Les certificats des sites en HTTPS, par exemple, sont décrits en ASN.1. Sur le web d'aujourd'hui, l'idée est la même, mais les outils ont changé : on parle plutôt de JSON, de XML et d'UTF-8.
L'encodage des caractères : d'ASCII à UTF-8#
Un ordinateur ne stocke pas des lettres, mais des nombres. Un encodage (ou jeu de caractères, charset) est la table qui dit quel nombre correspond à quelle lettre. Si l'émetteur et le récepteur n'utilisent pas la même table, le texte arrive déformé.
| Encodage | Caractères couverts | Octets pour « é » | Usage courant |
|---|---|---|---|
| ASCII | 128 caractères : lettres sans accent, chiffres, ponctuation | Aucun : « é » n'existe pas | Base commune de tous les autres |
| ISO-8859-1 (Latin-1) | 256 caractères, dont les accents d'Europe de l'Ouest | E9 (1 octet) | Anciens sites et logiciels |
| Windows-1252 | Variante de Latin-1 enrichie (guillemets typographiques, symbole euro…) | E9 (1 octet) | Fichiers créés sous Windows, exports d'anciens logiciels |
| UTF-8 (RFC 3629) | Tous les caractères d'Unicode, de toutes les langues, emojis compris | C3 A9 (2 octets) | Le standard du web, des e-mails et des API |
UTF-8 a un atout majeur : les 128 caractères d'ASCII y gardent exactement les mêmes valeurs, sur un seul octet. Les autres caractères prennent de 2 à 4 octets.
Pourquoi « Café » devient « Café »#
Ce défaut bien connu est un problème de couche 6. Le mot « Café » est enregistré en UTF-8 : le « é » occupe les deux octets C3 A9. Si le navigateur ou le logiciel croit lire du Latin-1 ou du Windows-1252, il lit chaque octet séparément : C3 s'affiche « à » et A9 s'affiche « © ». Résultat : « Café ». L'inverse existe aussi : un texte en Windows-1252 lu comme de l'UTF-8 fait apparaître des losanges avec un point d'interrogation, car l'octet E9 seul n'est pas valide en UTF-8.
Causes fréquentes : une base de données dans un autre encodage que les pages, ou un serveur qui annonce un mauvais charset.
Le fichier CSV qui s'ouvre mal dans Excel#
Autre cas quotidien : vous exportez la liste de vos clients depuis un logiciel, vous l'ouvrez dans Excel et les accents sont cassés. Un fichier CSV ne contient aucune indication de son encodage : le tableur doit le deviner, et il se trompe parfois. Deux réflexes : utiliser l'import de fichier texte d'Excel (onglet Données) en choisissant explicitement UTF-8, ou enregistrer au format « CSV UTF-8 » quand le logiciel le propose.
Sous Linux ou macOS, deux commandes permettent de diagnostiquer et de convertir. Exemple sur un fichier fictif clients.csv exporté depuis un ancien logiciel :
file -i clients.csv
clients.csv: text/plain; charset=iso-8859-1
iconv -f WINDOWS-1252 -t UTF-8 clients.csv > clients-utf8.csv
file -i clients-utf8.csv
clients-utf8.csv: text/plain; charset=utf-8file -i examine les octets et devine l'encodage : ici, il propose ISO-8859-1, car pour les lettres accentuées courantes, Latin-1 et Windows-1252 sont identiques. iconv convertit ensuite le fichier : -f indique l'encodage d'origine (from), -t l'encodage voulu (to). Gardez toujours l'original : une conversion faite avec le mauvais encodage de départ produit justement des « é ».
Formats et sérialisation : JSON, XML, images#
Au-delà des caractères, il faut s'entendre sur la structure des données. Transformer des données en mémoire (une fiche client, une commande) en une suite d'octets transportable s'appelle la sérialisation. C'est exactement l'idée de syntaxe de transfert de la norme.
- JSON : le format des API web, lisible par un humain, en UTF-8.
- XML : plus verbeux, toujours utilisé pour les flux RSS, les sitemaps ou les factures électroniques.
- Les images : JPEG, PNG, WebP et AVIF sont des représentations différentes d'une même photo, chacune avec sa propre façon de la décrire et de la compresser.
Sur le web, c'est l'en-tête HTTP Content-Type qui annonce au navigateur ce qu'il reçoit : text/html; charset=UTF-8 pour une page, application/json pour une réponse d'API, image/avif pour une image. Si cet en-tête annonce un mauvais format ou un mauvais encodage, le navigateur interprète mal des octets pourtant corrects.
La compression : gzip et Brotli#
Le texte d'une page web (HTML, CSS, JavaScript) contient beaucoup de répétitions, que la compression remplace par des références plus courtes, sans rien perdre. Deux méthodes dominent sur le web :
- gzip (RFC 1952) : ancienne, universelle, comprise par tous les navigateurs.
- Brotli (RFC 7932) : plus récente, elle embarque notamment un dictionnaire de mots et de fragments fréquents, ce qui l'aide à mieux compresser le texte.
Le dialogue se fait en deux en-têtes. Le navigateur annonce ce qu'il sait décompresser avec Accept-Encoding: br, gzip. Le serveur choisit parmi ces méthodes et indique son choix avec Content-Encoding. Si cet en-tête est absent, le contenu n'est pas compressé.
Les images JPEG, PNG, WebP et AVIF, elles, sont déjà compressées par leur propre format : les recompresser avec gzip ne fait presque rien gagner. Notre article sur les optimisations Nginx montre comment activer et régler cette compression côté serveur.
Le chiffrement : TLS, un cas difficile à classer#
Dans de nombreux cours et schémas, le chiffrement est présenté comme une tâche de la couche 6, et TLS, le protocole qui fait le « S » de HTTPS, y est rangé. C'est une convention pédagogique pratique, mais elle mérite une nuance honnête :
- TLS fonctionne au-dessus de TCP (couche 4) et assure lui-même l'ouverture d'une session chiffrée, ce qui ressemble aussi à de la couche 5.
- Il est intégré à l'application : c'est le navigateur et le serveur web qui le mettent en œuvre, pas le système réseau.
- Internet ne repose pas sur le modèle OSI mais sur le modèle TCP/IP (RFC 1122), qui n'a pas de couche session ni de couche présentation. Encodage, compression et chiffrement y vivent dans la couche application, ou dans une sous-couche comme TLS glissée entre l'application et TCP.
Retenez l'idée plutôt que la case : le chiffrement transforme la représentation des données pour la rendre illisible à un tiers, d'où son rattachement à la présentation. Le certificat, lui, est une carte d'identité numérique signée par une autorité de certification, qui prouve au navigateur qu'il parle bien au bon site. Pour la partie réseau, notre article sur le port 443 explique où passe le trafic HTTPS.
Bon à savoir : l'ordre compte. On compresse avant de chiffrer, jamais l'inverse : des données bien chiffrées ressemblent à du hasard et ne se compressent quasiment plus. C'est pour cela que la compression se fait au niveau de HTTP, avant que TLS ne chiffre le résultat.
Ce que l'on observe sur websource.fr#
Pour voir la couche 6 à l'œuvre, demandez à curl les seuls en-têtes de la page d'accueil, en annonçant les compressions acceptées :
curl -sI -H 'Accept-Encoding: br, gzip' https://www.websource.fr/ | grep -iE '^content-(type|encoding)'
content-type: text/html; charset=UTF-8
content-encoding: brRelevé le 22 octobre 2026 vers 9 h UTC. La première ligne dit : « ceci est une page HTML, encodée en UTF-8 ». La seconde : « elle a été compressée avec Brotli ».
Surprise instructive : en téléchargeant réellement la page (requête GET, et non HEAD comme avec -I), la réponse est revenue en gzip, à chaque essai. Le serveur, ou ici Cloudflare placé devant lui, choisit librement parmi les méthodes acceptées. Voici les tailles mesurées le même jour, avec et sans compression :
| Ressource | Type annoncé | Taille sans compression | Taille compressée | Méthode reçue |
|---|---|---|---|---|
| Page d'accueil | text/html; charset=UTF-8 | 341 793 octets | 72 941 octets | gzip |
| Feuille de style principale | text/css | 439 460 octets | 69 359 octets | gzip |
| Script JavaScript de la page d'accueil | text/javascript | 39 009 octets | 10 961 octets | Brotli |
Pour reproduire la mesure : curl -s -o /dev/null -D - -H 'Accept-Encoding: br, gzip' -w '%{size_download}\n' https://www.websource.fr/ affiche les en-têtes reçus et la taille réellement transférée. Sans l'option -H, curl n'annonce aucune compression et reçoit la page entière. Sur ces trois fichiers texte, la compression divise le volume transféré par un facteur compris entre environ 3,5 et 6,3 : c'est autant de données en moins sur le réseau mobile de vos visiteurs.
Un hébergement qui parle la bonne langue#
Accents cassés, pages non compressées, certificat expiré : ces problèmes de présentation se règlent le plus souvent dans la configuration de l'hébergement. Websource héberge un grand nombre de sites et accompagne ses clients dès la commande : nos offres d'hébergement web démarrent dès 4,99 € HT/mois, avec le premier mois offert, et nous vous aidons à vérifier l'encodage, la compression et le HTTPS de votre site.
Prochain article de la série : la couche 7, la couche application, celle des protocoles que vous utilisez directement, comme HTTP, DNS ou SMTP.
Questions fréquentes#
À quoi sert la couche 6 du modèle OSI ?#
Elle garantit que les données gardent le même sens d'une machine à l'autre. On lui attribue l'encodage des caractères, le format des données, la compression et, dans beaucoup d'explications, le chiffrement.
Pourquoi mon site affiche-t-il « é » à la place des accents ?#
Parce qu'un texte enregistré en UTF-8 est lu comme s'il était en Latin-1 ou en Windows-1252. Il faut que les fichiers, la base de données et l'en-tête Content-Type annoncé par le serveur utilisent tous le même encodage, de préférence UTF-8.
Quelle différence entre gzip et Brotli ?#
Ce sont deux méthodes de compression sans perte. gzip est ancienne et comprise partout ; Brotli, plus récente, dispose d'un dictionnaire intégré qui l'aide à compresser le texte. Le serveur choisit parmi les méthodes que le navigateur déclare accepter.
TLS appartient-il à la couche 6 ?#
C'est une convention pédagogique fréquente, mais pas une vérité stricte. TLS fonctionne au-dessus de TCP et il est mis en œuvre par les applications ; dans le modèle TCP/IP, qui est celui d'Internet, il n'y a pas de couche présentation.
Comment convertir un fichier CSV en UTF-8 ?#
Sous Linux ou macOS, la commande iconv -f WINDOWS-1252 -t UTF-8 fichier.csv > fichier-utf8.csv convertit un fichier venu d'un ancien logiciel Windows. Dans Excel, choisissez l'enregistrement au format CSV UTF-8 ou l'import de fichier texte avec l'encodage UTF-8.
Article publié le 05/11/2026 sous la signature de Jonathan Gutierrez, rédigé à partir des sources citées ci-dessus, puis relu avant publication. Une information vous semble inexacte ou datée ? Signalez-le nous, nous corrigeons.