TL;DRLe load balancing répartit les visiteurs d'un site entre plusieurs serveurs pour qu'il reste en ligne même quand l'un d'eux tombe, et pour absorber plus de trafic. Voici comment fonctionne un répartiteur de charge, les choix à faire, deux configurations commentées, et la question honnête : en avez-vous vraiment besoin ?
Le load balancing en une phrase#
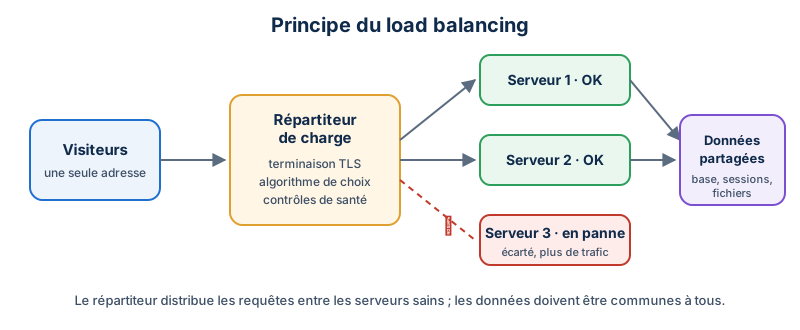
Le load balancing, ou répartition de charge, consiste à placer devant plusieurs serveurs identiques un équipement ou un logiciel, le répartiteur de charge (load balancer), qui reçoit toutes les requêtes des visiteurs et les distribue entre ces serveurs. Le visiteur ne voit qu'une seule adresse ; derrière, deux, trois ou cinquante machines se partagent le travail.
Le répartiteur ne se contente pas de distribuer : il vérifie en permanence que chaque serveur répond correctement et cesse d'envoyer du trafic à celui qui tombe en panne. C'est ce second rôle qui, pour beaucoup de sites, compte le plus.
À quoi sert la répartition de charge ?#
La haute disponibilité#
Avec un seul serveur, la moindre panne, mise à jour du système ou saturation rend le site inaccessible. Avec deux serveurs ou plus derrière un répartiteur, la panne de l'un n'interrompt pas le service : le répartiteur le détecte et envoie tout le trafic aux autres. On peut aussi retirer volontairement un serveur pour le mettre à jour, puis le remettre, sans coupure visible.
La performance et la montée en charge#
Quand un serveur ne suffit plus à absorber le trafic, on peut soit le remplacer par un plus gros (montée en charge verticale), soit en ajouter d'autres à côté (montée en charge horizontale). Le load balancing rend la seconde option possible : chaque serveur ajouté prend sa part des requêtes.
Deux objectifs à ne pas confondre#
Disponibilité et performance ne se règlent pas de la même façon. Un site peu fréquenté mais qui ne doit jamais s'arrêter a besoin de redondance, pas de puissance. Un site lent à cause d'une application mal optimisée ne deviendra pas rapide en ajoutant des serveurs : chaque requête restera aussi lente, simplement répartie ailleurs. Avant d'envisager un répartiteur, il faut savoir lequel de ces deux problèmes on cherche à résoudre.
Niveau 4 ou niveau 7 : ce que voit le répartiteur#
Les répartiteurs se classent selon la couche du modèle OSI à laquelle ils prennent leur décision.
| Niveau 4 (transport) | Niveau 7 (application) | |
|---|---|---|
| Ce qu'il voit | Adresses IP et ports, connexions TCP ou UDP | Le contenu HTTP : adresse demandée, en-têtes, cookies |
| Ce qu'il peut décider | Vers quel serveur envoyer une connexion entière | Vers quel groupe de serveurs envoyer chaque requête, selon l'URL ou un cookie |
| Chiffrement | Peut transmettre le TLS sans le déchiffrer | Doit déchiffrer le TLS pour lire la requête |
| Usages typiques | Bases de données, messagerie, tout protocole non HTTP | Sites et API web, routage /api vers d'autres serveurs, sessions persistantes par cookie |
| Dans HAProxy | mode tcp | mode http |
Pour un site web, le niveau 7 est le plus courant, parce qu'il permet les contrôles de santé HTTP, les cookies de persistance et l'ajout d'en-têtes comme X-Forwarded-For, qui transmet au serveur l'adresse IP réelle du visiteur.
Les algorithmes de répartition#
À chaque nouvelle requête ou connexion, le répartiteur choisit un serveur selon une règle, l'algorithme de répartition. Les plus répandus :
| Algorithme | Principe | Adapté quand… | Nom dans HAProxy / Apache / Nginx |
|---|---|---|---|
| Round robin (tourniquet) | Chaque serveur à tour de rôle | Les serveurs sont identiques et les requêtes de durée comparable | roundrobin / byrequests / par défaut |
| Pondéré | Tour de rôle ou moindre charge, mais un serveur au poids double reçoit deux fois plus | Les serveurs n'ont pas la même puissance | weight / loadfactor / weight |
| Least connections (moins de connexions) | Le serveur qui traite le moins de connexions en cours | Certaines requêtes durent beaucoup plus que d'autres (exports, API lentes) | leastconn / bybusyness / least_conn |
| IP hash (hachage de l'adresse source) | Un calcul sur l'adresse IP du visiteur désigne toujours le même serveur | On veut qu'un visiteur retombe sur le même serveur sans cookie | source / (aucun équivalent natif) / ip_hash |
L'IP hash a une limite : tous les visiteurs d'une même entreprise ou d'un même opérateur mobile, qui sortent souvent par une adresse commune, atterrissent sur le même serveur. Et si le nombre de serveurs change, une partie des visiteurs change de serveur.
Les contrôles de santé (health checks)#
Un répartiteur qui enverrait du trafic à un serveur éteint serait pire que pas de répartiteur du tout. Il interroge donc régulièrement chaque serveur, par exemple en demandant une page /sante toutes les cinq secondes. Après plusieurs échecs consécutifs, le serveur est retiré de la rotation ; après plusieurs réussites, il y revient.
Deux conseils pratiques :
- Une page de santé qui teste vraiment l'application. Un serveur web peut répondre « 200 » sur un fichier statique alors que l'application ou sa connexion à la base est en panne. La page de contrôle doit passer par l'application, sans être trop lourde, puisqu'elle est appelée en permanence.
- Des seuils qui évitent le yo-yo. Exiger trois échecs pour retirer un serveur et deux succès pour le réintégrer évite qu'un ralentissement passager le fasse entrer et sortir sans arrêt.
Si tous les serveurs sont déclarés hors service, le répartiteur n'a plus personne à qui transmettre : HAProxy répond alors par une erreur 503. Un serveur qui renvoie une réponse invalide ou ne répond pas à temps donne, côté visiteur, une erreur 502 ou une erreur 504.
Sessions persistantes : le piège des paniers qui se vident#
Par défaut, PHP enregistre les sessions (connexion à l'espace client, contenu du panier) dans des fichiers sur le disque du serveur qui a traité la requête. Si la requête suivante part sur un autre serveur, celui-ci ne connaît pas la session : le visiteur se retrouve déconnecté, ou son panier paraît vide.
Deux réponses existent :
- Les sessions persistantes (sticky sessions) : le répartiteur pose un cookie qui indique le serveur choisi et y renvoie toujours le même visiteur. C'est simple, mais la charge se répartit moins bien, et si ce serveur tombe, ses visiteurs perdent quand même leur session.
- Le stockage des sessions hors du serveur : toutes les machines lisent et écrivent les sessions au même endroit, dans Redis, Memcached ou la base de données. N'importe quel serveur peut alors traiter n'importe quelle requête, et la panne d'une machine ne déconnecte personne.
La seconde solution est la plus robuste ; les deux se combinent souvent. Notre article sur le cache Memcache et Redis explique comment vérifier que ces services sont réellement utilisés par votre CMS. La même logique vaut pour les fichiers envoyés par les utilisateurs (images, PDF) : ils doivent être sur un stockage commun, sinon une image envoyée sur le serveur 1 sera introuvable depuis le serveur 2.
Bon à savoir : la base de données est souvent le point faible oublié. Trois serveurs web derrière un répartiteur, mais une seule base de données, c'est encore un point unique de défaillance. La haute disponibilité se raisonne sur toute la chaîne : répartiteur, serveurs, base, stockage, et même le répartiteur lui-même, qu'on double souvent avec une adresse IP flottante.
La terminaison TLS#
Pour lire une requête HTTPS, un répartiteur de niveau 7 doit la déchiffrer. On parle de terminaison TLS : le certificat est installé sur le répartiteur, qui dialogue en HTTPS avec les visiteurs sur le port 443. Vers les serveurs, le trafic repart soit en clair sur un réseau privé, soit rechiffré si le réseau n'est pas de confiance.
Avantages : un seul endroit où renouveler les certificats, et des serveurs déchargés du chiffrement. Conséquence à ne pas oublier : l'application reçoit désormais des requêtes en HTTP venant de l'adresse du répartiteur. Elle doit faire confiance aux en-têtes X-Forwarded-For et X-Forwarded-Proto (ou à l'en-tête normalisé Forwarded), sans quoi elle croit que le site est en HTTP et peut boucler sur des redirections vers HTTPS. Dans Symfony, c'est le réglage des trusted proxies.
Le DNS round robin et ses limites#
La forme la plus simple de répartition ne demande aucun équipement : déclarer plusieurs adresses IP pour le même nom dans le DNS. Les résolveurs les renvoient dans un ordre qui varie, et les visiteurs se répartissent à peu près entre les serveurs. Ce principe est décrit depuis 1995 dans la RFC 1794.
Ses limites sont importantes :
- Aucun contrôle de santé : le DNS continue de donner l'adresse d'un serveur en panne. Certains navigateurs essaient l'adresse suivante, mais ce n'est pas garanti.
- Les caches DNS : retirer une adresse ne prend effet qu'à l'expiration de la durée de vie (TTL) des enregistrements dans les résolveurs.
- Une répartition grossière : le DNS ignore la charge réelle de chaque serveur.
- Pas de session persistante : un visiteur peut changer de serveur d'une requête à l'autre.
Le DNS round robin dépanne pour répartir entre plusieurs répartiteurs ou plusieurs sites géographiques, mais il ne remplace pas un vrai répartiteur. Pour revoir les bases, lisez notre article sur le fonctionnement d'un serveur DNS.
Ce que l'on observe sur websource.fr#
Le site websource.fr passe par Cloudflare en frontal. Cela se vérifie avec curl :
$ curl -sI https://www.websource.fr/ | grep -iE '^(server|cf-ray|cf-cache-status)'
server: cloudflare
cf-cache-status: DYNAMIC
cf-ray: a4c05abc1849a9b8-CDG
Relevé le 17 octobre 2026 à 15 h 32 UTC, sur trois requêtes successives. Le suffixe CDG du cf-ray désigne le centre de données Cloudflare qui a répondu (ici Paris), et DYNAMIC indique que la page HTML n'a pas été servie depuis le cache de Cloudflare mais demandée à notre serveur. La résolution DNS de www.websource.fr renvoie deux adresses IPv4 et deux IPv6, qui appartiennent à Cloudflare : ce réseau annonce les mêmes adresses depuis de nombreux centres de données (anycast), et chaque visiteur est dirigé vers l'un des plus proches.
Il ne faut pas en tirer plus que ce que c'est : dans notre cas, Cloudflare joue le rôle de proxy inverse (chiffrement côté visiteur, filtrage, cache des fichiers statiques), pas celui d'un répartiteur entre plusieurs serveurs d'origine. La répartition de charge entre plusieurs origines est un service distinct chez Cloudflare, comme chez les autres fournisseurs.
Exemples de configuration commentés#
Les deux configurations ci-dessous sont des exemples pédagogiques, pas notre infrastructure. Les adresses 192.0.2.x sont réservées à la documentation (RFC 5737) : remplacez-les par celles de vos serveurs. Nous les avons validées le 17 octobre 2026 avec haproxy -c (HAProxy 3.0.11, paquet Debian 13) et apache2 -t (Apache 2.4.69), ce qui garantit la syntaxe, pas le fonctionnement sur votre réseau.
HAProxy : trois serveurs, un secours, terminaison TLS#
global
    log /dev/log local0
    maxconn 4096

defaults
    mode http                 # répartition de niveau 7 (HTTP)
    log global
    option httplog
    option forwardfor         # transmet l'IP du visiteur dans X-Forwarded-For
    timeout connect 5s
    timeout client  30s
    timeout server  30s

frontend site_web
    bind :80
    bind :443 ssl crt /etc/haproxy/certs/exemple.fr.pem   # terminaison TLS ici
    http-request redirect scheme https unless { ssl_fc }
    default_backend serveurs_app

backend serveurs_app
    balance leastconn                        # serveur le moins occupé
    option httpchk                           # contrôle de santé HTTP
    http-check send meth GET uri /sante
    http-check expect status 200
    cookie SRV insert indirect nocache       # session persistante par cookie
    server app1 192.0.2.11:80 check inter 5s fall 3 rise 2 cookie app1 weight 100
    server app2 192.0.2.12:80 check inter 5s fall 3 rise 2 cookie app2 weight 100
    server app3 192.0.2.13:80 check inter 5s fall 3 rise 2 cookie app3 weight 50
    server secours 192.0.2.20:80 check backup  # n'est utilisé que si tous les autres tombent
Le serveur app3 a un poids de 50 contre 100 pour les deux autres : il reçoit environ moitié moins de trafic. Le serveur secours ne travaille que si les trois premiers sont hors service. Pour tester une modification avant de recharger le service : haproxy -c -f /etc/haproxy/haproxy.cfg.
Apache : mod_proxy_balancer#
# Modules : a2enmod proxy proxy_http proxy_balancer lbmethod_byrequests slotmem_shm headers proxy_hcheck
<VirtualHost *:80>
    ServerName exemple.fr

    # Contrôle de santé : GET /sante toutes les 5 s, attendu en 2xx/3xx
    ProxyHCExpr reponse_ok {%{REQUEST_STATUS} =~ /^[23]/}

    # Cookie qui retient le serveur choisi (session persistante)
    Header add Set-Cookie "ROUTEID=.%{BALANCER_WORKER_ROUTE}e; path=/" env=BALANCER_ROUTE_CHANGED

    <Proxy "balancer://serveurs_app">
        # loadfactor = poids : app1 et app2 reçoivent deux fois plus de requêtes qu'app3
        BalancerMember "http://192.0.2.11:80" route=app1 loadfactor=2 hcmethod=GET hcuri=/sante hcexpr=reponse_ok hcinterval=5 hcfails=3 hcpasses=2
        BalancerMember "http://192.0.2.12:80" route=app2 loadfactor=2 hcmethod=GET hcuri=/sante hcexpr=reponse_ok hcinterval=5 hcfails=3 hcpasses=2
        BalancerMember "http://192.0.2.13:80" route=app3 loadfactor=1 hcmethod=GET hcuri=/sante hcexpr=reponse_ok hcinterval=5 hcfails=3 hcpasses=2
        # Serveur de secours (hot standby), utilisé seulement si tous les autres sont hors service
        BalancerMember "http://192.0.2.20:80" status=+H
        ProxySet lbmethod=byrequests stickysession=ROUTEID
    </Proxy>

    ProxyPreserveHost On
    ProxyPass        "/" "balancer://serveurs_app/"
    ProxyPassReverse "/" "balancer://serveurs_app/"
</VirtualHost>
Apache propose quatre méthodes de répartition, chacune dans son propre module : byrequests (nombre de requêtes, pondéré par loadfactor), bytraffic (volume d'octets), bybusyness (requêtes en cours, l'équivalent du least connections) et heartbeat. Les contrôles de santé actifs viennent du module mod_proxy_hcheck. Testez avec apache2ctl configtest avant tout rechargement.
Managé ou auto-hébergé : quelles solutions ?#
- Les répartiteurs managés des fournisseurs cloud (AWS Elastic Load Balancing, Google Cloud Load Balancing, OVHcloud, Scaleway, Cloudflare…) : rien à installer, redondance du répartiteur assurée par le fournisseur, facturation à l'usage. En contrepartie, la configuration dépend de leur interface et de leurs options.
- HAProxy : logiciel libre spécialisé dans la répartition de charge, de niveau 4 et 7, avec contrôles de santé actifs, persistance par cookie et statistiques détaillées.
- Nginx : très utilisé comme proxy inverse et répartiteur. Dans la version libre, les algorithmes
round robin,least_conn,ip_hashethashsont disponibles, mais les contrôles de santé actifs sont réservés à l'offre commerciale NGINX Plus ; la version libre se contente de contrôles passifs (un serveur en échec est écarté pendant un temps donné). - Apache avec mod_proxy_balancer : pratique si Apache est déjà en place et que les besoins restent simples.
Une PME a-t-elle vraiment besoin d'un load balancer ?#
Le plus souvent, non. Pour un site vitrine, un blog ou une boutique au trafic régulier, un seul serveur correctement dimensionné, avec un cache de pages, un cache d'objets et un CDN pour les fichiers statiques, tient la charge sans difficulté. Le load balancing ajoute de vraies contraintes : au moins deux serveurs à maintenir, des fichiers et des sessions à partager, des déploiements à synchroniser, une base de données qui devient à son tour le point faible. Avant d'y penser, mesurez : notre article sur le TTFB montre comment savoir si la lenteur vient du serveur ou de l'application.
Il devient pertinent quand :
- une interruption de quelques minutes coûte plus cher que l'infrastructure redondante (vente en ligne à fort enjeu, service utilisé par vos clients en continu) ;
- le trafic connaît des pics prévisibles qu'un seul serveur, même optimisé, ne peut pas absorber (soldes, campagne télé, billetterie) ;
- vous devez mettre à jour vos serveurs sans aucune coupure ;
- l'application est déjà conçue pour tourner sur plusieurs machines (sessions et fichiers partagés).
Un hébergement bien réglé avant tout#
Dans la grande majorité des cas, la bonne réponse à « mon site est lent » ou « mon site tombe » est d'abord un hébergement adapté et bien configuré. Websource héberge un grand nombre de sites et accompagne ses clients dès la commande : nos offres d'hébergement web démarrent dès 4,99 € HT/mois, et si votre site existe déjà ailleurs, sa migration est offerte avec les offres Premium et Advanced, et réalisée sur devis avec l'offre Standard. Pour une architecture à plusieurs serveurs, notre article sur l'infogérance serveur détaille ce que nous prenons en charge, et nous étudions votre besoin réel avant de proposer un répartiteur.
Questions fréquentes#
Quelle est la différence entre load balancing et répartition de charge ?#
Aucune : répartition de charge est la traduction française de load balancing. Le load balancer, ou répartiteur de charge, est l'équipement ou le logiciel qui distribue les requêtes entre plusieurs serveurs.
Un load balancer rend-il un site plus rapide ?#
Il permet d'absorber plus de visiteurs simultanés en ajoutant des serveurs, mais il ne rend pas chaque page plus rapide. Une page lente à cause de l'application restera lente, simplement servie par plusieurs machines.
Qu'est-ce qu'un health check ?#
C'est le contrôle régulier que le répartiteur fait de chaque serveur, par exemple en demandant une page de santé toutes les quelques secondes. Un serveur qui échoue plusieurs fois de suite est retiré de la rotation jusqu'à ce qu'il réponde de nouveau.
Pourquoi les visiteurs sont-ils déconnectés derrière un load balancer ?#
Parce que les sessions sont enregistrées sur le disque du serveur qui a traité la requête précédente. Il faut soit des sessions persistantes, qui renvoient un visiteur toujours vers le même serveur, soit un stockage commun des sessions comme Redis ou la base de données.
Le DNS round robin suffit-il ?#
Rarement : le DNS ne vérifie pas que les serveurs fonctionnent et les caches retardent le retrait d'une adresse. Il peut compléter un vrai répartiteur, par exemple entre plusieurs sites géographiques, mais pas le remplacer.
Article publié le 20/10/2026 sous la signature de Jonathan Gutierrez, rédigé à partir des sources citées ci-dessus, puis relu avant publication. Une information vous semble inexacte ou datée ? Signalez-le nous, nous corrigeons.