TL;DRKubernetes fait tourner vos conteneurs Docker sur plusieurs serveurs, les remplace quand ils tombent et les met à jour sans coupure. Encore faut-il choisir le bon type d'objet : Deployment, StatefulSet, DaemonSet ou CronJob. Ce guide explique l'architecture d'un cluster, chaque type d'objet et le vocabulaire essentiel, montre un déploiement complet avec k3s et partage ce que nous avons appris en migrant nos hébergements.
Kubernetes en une phrase#
Kubernetes (souvent abrégé K8s) est un orchestrateur de conteneurs : un logiciel qui fait tourner vos conteneurs sur plusieurs serveurs, les redémarre quand ils tombent, les met à jour sans coupure et ajoute des copies quand la charge augmente. Vous décrivez l'état que vous voulez (« deux copies de mon site, avec telle image, accessibles à telle adresse ») et Kubernetes travaille en permanence pour que la réalité corresponde à cette description.
Un conteneur est une application emballée avec tout ce dont elle a besoin pour fonctionner (code, bibliothèques, configuration), lancée de façon isolée sur un serveur. Si ce mot est nouveau pour vous, commencez par notre article Docker : comprendre les conteneurs, les images et le Dockerfile. Docker fabrique et lance un conteneur sur une machine ; Kubernetes gère des dizaines ou des centaines de conteneurs sur un groupe de machines.
Le nom vient du grec et signifie « timonier » ou « pilote ». Le projet a été publié en open source par Google en 2014 et il est aujourd'hui maintenu par la Cloud Native Computing Foundation (CNCF).
Ce guide sert de référence. Il explique l'architecture d'un cluster, détaille chaque type d'objet (pod, Deployment, StatefulSet, DaemonSet, Job, CronJob), définit le vocabulaire indispensable, puis montre pas à pas comment déployer une application PHP avec k3s. Il se termine par ce que nous avons appris chez Websource en migrant nos hébergements vers Kubernetes.
L'architecture d'un cluster Kubernetes#
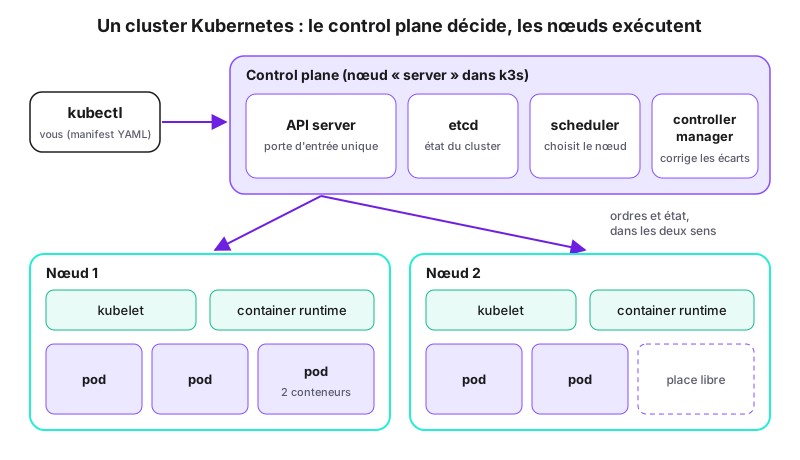
Un cluster est un ensemble de serveurs qui travaillent ensemble sous le contrôle de Kubernetes. Chaque serveur du cluster s'appelle un nœud (node). Un nœud peut être une machine physique ou une machine virtuelle.
Le control plane : le cerveau#
Le control plane (plan de contrôle) prend les décisions pour tout le cluster. Il se compose de quatre éléments principaux :
- L'API server (
kube-apiserver) est la porte d'entrée unique. Tout passe par lui : vos commandes, mais aussi les échanges entre les composants du cluster. - etcd est la base de données clé-valeur qui conserve l'état du cluster : quels objets existent, avec quelle configuration. Si etcd est perdu sans sauvegarde, le cluster ne sait plus ce qu'il doit faire tourner.
- Le scheduler (
kube-scheduler, « ordonnanceur ») choisit sur quel nœud placer chaque nouveau pod, en fonction des ressources disponibles et des contraintes que vous avez fixées. - Le controller manager (
kube-controller-manager) fait tourner les contrôleurs : des boucles qui comparent en permanence l'état souhaité à l'état réel et corrigent les écarts. Un pod disparaît alors qu'on en veut deux ? Le contrôleur en recrée un.
Les nœuds : les bras#
Sur chaque nœud qui exécute des applications, on trouve :
- Le kubelet, un agent qui reçoit de l'API server la liste des pods à faire tourner sur ce nœud, les démarre, les surveille et remonte leur état.
- Le container runtime (moteur d'exécution de conteneurs), qui lance réellement les conteneurs. Le plus répandu est containerd. Kubernetes n'utilise plus Docker lui-même pour lancer les conteneurs depuis la version 1.24, mais les images construites avec Docker fonctionnent sans changement, car elles respectent le même format standard (OCI).
- kube-proxy, qui programme les règles réseau pour que les Services (voir plus bas) acheminent le trafic vers les bons pods.
k3s, une distribution Kubernetes légère#
Installer Kubernetes « à la main » demande d'assembler beaucoup de pièces. Une distribution les livre prêtes à l'emploi. k3s, publiée par Rancher et aujourd'hui projet de la CNCF, tient en un seul binaire et embarque tout le nécessaire : containerd, le réseau des pods (Flannel), le DNS interne (CoreDNS), l'Ingress controller Traefik, un fournisseur de stockage local (local-path) et metrics-server, qui mesure la consommation des pods.
Dans k3s, un nœud du control plane s'appelle un server et un nœud qui exécute seulement des applications un agent. Par défaut, un server unique stocke l'état du cluster dans SQLite plutôt que dans etcd ; etcd embarqué s'active pour faire tourner plusieurs servers en haute disponibilité. C'est la distribution que nous utilisons chez Websource, sur deux serveurs dédiés : un nœud control plane et un nœud worker.
Le manifest YAML : décrire plutôt qu'ordonner#
Avec Kubernetes, on ne dit pas « lance ce conteneur ». On écrit un manifest : un fichier texte au format YAML qui décrit un objet et l'état voulu. Tout manifest contient quatre parties :
apiVersion: la version de l'API qui définit ce type d'objet (v1,apps/v1,batch/v1…) ;kind: le type d'objet (Deployment,Service…) ;metadata: son nom, son namespace et ses labels ;spec: l'état souhaité, propre à chaque type d'objet.
On envoie le manifest au cluster avec kubectl, l'outil en ligne de commande de Kubernetes : kubectl apply -f fichier.yaml. La même commande sert à créer et à mettre à jour, ce qui permet de garder ses manifests dans Git et de les rejouer à l'identique.
Deux notions reviennent partout :
- Namespace (espace de noms) : un dossier logique qui regroupe des objets et sépare les environnements ou les équipes. Deux objets peuvent porter le même nom s'ils sont dans deux namespaces différents. Les composants de Kubernetes vivent dans
kube-system. - Label et selector : un label est une étiquette clé-valeur posée sur un objet (
app: mon-site) ; un selector est un filtre qui retrouve les objets portant certaines étiquettes. C'est ainsi qu'un Deployment sait quels pods lui appartiennent et qu'un Service sait vers quels pods envoyer le trafic.
Les types d'objets qui font tourner vos conteneurs#
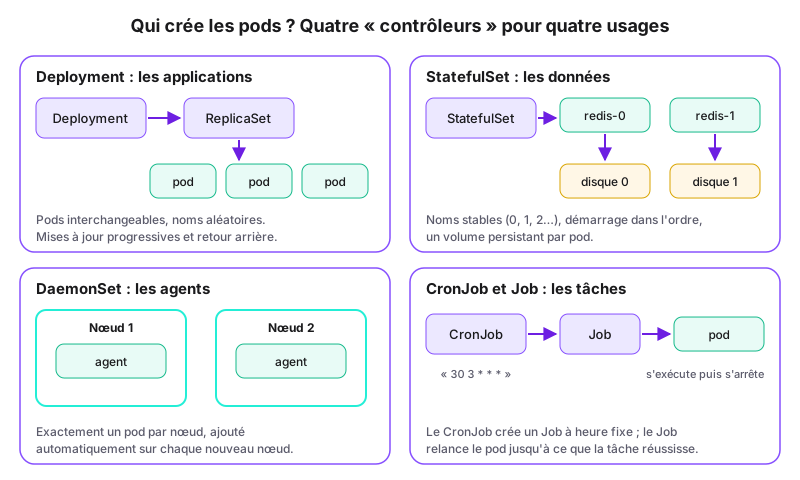
C'est le point qui déroute le plus au début : dans Kubernetes, on ne crée presque jamais un conteneur directement. On choisit un type d'objet, parfois appelé à tort « type de conteneur », qui dit comment les conteneurs doivent vivre : en plusieurs copies interchangeables, avec un disque attitré, un exemplaire par serveur, ou le temps d'une tâche.
Le pod : la plus petite unité#
Le pod est la plus petite unité que Kubernetes sait déployer. Il contient un ou plusieurs conteneurs qui partagent la même adresse IP, peuvent se parler par localhost et peuvent partager des volumes. Dans la grande majorité des cas, un pod contient un seul conteneur.
Un pod est éphémère : s'il meurt, il n'est pas réparé, il est remplacé par un nouveau pod, avec une nouvelle adresse IP. C'est pourquoi on ne crée presque jamais de pod seul : on confie ce travail à un contrôleur (Deployment, StatefulSet…) qui le recrée au besoin.
Les pods à plusieurs conteneurs : init container et sidecar#
Quand deux processus doivent vivre ensemble, on les place dans le même pod :
- Un init container (conteneur d'initialisation) s'exécute avant les conteneurs principaux, jusqu'au bout, puis s'arrête. Il sert à préparer le terrain : créer un dossier avec les bons droits, attendre qu'un service soit disponible, régler le réseau du pod. Si plusieurs init containers sont déclarés, ils s'exécutent l'un après l'autre.
- Un sidecar (le « side-car » d'une moto) est un conteneur auxiliaire qui tourne à côté du conteneur principal pendant toute la vie du pod : relais réseau, envoi des journaux, proxy. La forme recommandée est aujourd'hui le sidecar natif (activé par défaut depuis Kubernetes 1.29, stable depuis la 1.33) : un init container déclaré avec
restartPolicy: Always. Il démarre avant l'application, reste actif et s'arrête après elle.
Nous utilisons les deux. Chaque site hébergé tourne dans un pod à deux conteneurs : le serveur web PHP et un sidecar qui relaie les connexions à la base MariaDB du serveur. Le site se connecte à 127.0.0.1:3306 comme avant, sans changer sa configuration ni ses droits SQL. Et pour les pods « de renfort » qui tournent sur l'autre serveur, un init container prépare le réseau du pod avant le démarrage du site. Voici le principe, simplifié et anonymisé :
apiVersion: v1
kind: Pod
metadata:
  name: exemple-sidecar
  namespace: demo
spec:
  initContainers:
    - name: preparation            # init container : s'exécute puis s'arrête
      image: busybox:1.36
      command: ["sh", "-c", "mkdir -p /partage/cache && chmod 777 /partage/cache"]
      volumeMounts:
        - name: partage
          mountPath: /partage
    - name: relais-db              # sidecar natif : restartPolicy Always
      image: alpine/socat
      restartPolicy: Always
      args: ["TCP-LISTEN:3306,bind=127.0.0.1,fork,reuseaddr", "UNIX-CONNECT:/run/mysqld/mysqld.sock"]
      volumeMounts:
        - name: mysqld
          mountPath: /run/mysqld
  containers:
    - name: web                    # le conteneur principal
      image: php:8.3-apache
      volumeMounts:
        - name: partage
          mountPath: /partage
  volumes:
    - name: partage
      emptyDir: {}                 # dossier temporaire partagé, vidé quand le pod disparaît
    - name: mysqld
      hostPath:                    # dossier du serveur monté dans le pod
        path: /run/mysqld
        type: Directory
Dans la vraie vie, ce modèle de pod est placé dans un Deployment, présenté juste après.
ReplicaSet : garder N copies#
Un ReplicaSet garantit qu'un nombre donné de pods identiques (les réplicas) tourne en permanence. Un pod disparaît, il en crée un autre ; il y en a un de trop, il en supprime un. Vous ne le manipulerez presque jamais directement : c'est le Deployment qui crée et gère les ReplicaSets pour vous.
Deployment : les applications#
Le Deployment est l'objet le plus utilisé. Il gère des pods interchangeables, dits « sans état » (stateless) : n'importe quelle copie peut répondre à n'importe quel visiteur, car rien d'important n'est stocké dans le pod lui-même. Les pods portent des noms aléatoires (mon-site-7d9f8c6b5-x2k4p).
Son atout : les mises à jour progressives (rolling update). Quand vous changez l'image, le Deployment crée un nouveau ReplicaSet, démarre les nouveaux pods un par un et n'arrête les anciens qu'une fois les nouveaux prêts. Il garde l'historique des versions, ce qui permet un retour arrière (rollback) en une commande.
À utiliser pour : sites web, API, applications PHP, Node.js ou Python, tout ce qui garde ses données ailleurs (base de données, stockage de fichiers, Redis).
StatefulSet : les données#
Le StatefulSet gère des pods « avec état » (stateful), qui ne sont pas interchangeables. Il leur garantit :
- des noms stables et numérotés :
redis-0,redis-1… Un pod remplacé reprend le même nom ; - un volume persistant attitré par pod, qui le suit même s'il change de nœud (quand le stockage le permet) ;
- un ordre de démarrage et d'arrêt :
redis-0d'abord, puisredis-1; - une adresse DNS stable par pod, grâce à un Service « headless » (sans adresse IP propre).
apiVersion: v1
kind: Service
metadata:
name: redis
namespace: demo
spec:
clusterIP: None # Service « headless » exigé par le StatefulSet
selector:
app: redis
ports:
- port: 6379
apiVersion: apps/v1
kind: StatefulSet
metadata:
name: redis
namespace: demo
spec:
serviceName: redis
replicas: 1
selector:
matchLabels:
app: redis
template:
metadata:
labels:
app: redis
spec:
containers:
- name: redis
image: valkey/valkey:8.1 # Valkey, compatible Redis
ports:
- containerPort: 6379
volumeMounts:
- name: data
mountPath: /data
volumeClaimTemplates: # un disque (PVC) par pod : data-redis-0, data-redis-1…
- metadata:
name: data
spec:
accessModes: ["ReadWriteOnce"]
storageClassName: local-path
resources:
requests:
storage: 1GiÀ utiliser pour : bases de données, files de messages, caches persistants, registre d'images. Chez nous, le registre d'images privé, Redis (sessions PHP) et le réplica MariaDB sont des StatefulSets. Attention : supprimer un StatefulSet ne supprime pas ses volumes, par sécurité.
DaemonSet : un agent sur chaque nœud#
Le DaemonSet fait tourner exactement un pod par nœud (ou par nœud choisi). Quand un nœud rejoint le cluster, le pod y est ajouté automatiquement ; quand il le quitte, le pod disparaît.
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
  namespace: demo
spec:
  selector:
    matchLabels:
      app: node-exporter
  template:
    metadata:
      labels:
        app: node-exporter
    spec:
      hostNetwork: true            # utilise le réseau du serveur
      hostPID: true                # voit les processus du serveur
      containers:
        - name: node-exporter
          image: quay.io/prometheus/node-exporter:v1.8.2
          args: ["--path.rootfs=/host"]
          volumeMounts:
            - name: root
              mountPath: /host
              readOnly: true
      volumes:
        - name: root
          hostPath:
path: /À utiliser pour : agents de supervision (comme node-exporter, qui mesure le processeur, la mémoire et les disques de chaque serveur), collecteurs de journaux, composants réseau. Chez nous, node-exporter et le routeur Traefik tournent en DaemonSet.
Job et CronJob : les tâches#
Un Job lance un ou plusieurs pods qui doivent aller au bout d'une tâche puis s'arrêter : une migration de base de données, un import, un calcul. Si le pod échoue, le Job le relance, dans la limite de backoffLimit tentatives.
Un CronJob crée un Job à heure fixe, avec la même syntaxe que la crontab Linux. C'est l'équivalent des tâches planifiées d'un hébergement classique.
apiVersion: batch/v1
kind: CronJob
metadata:
  name: rapport-nuit
  namespace: demo
spec:
  schedule: "30 3 * * *"           # tous les jours à 3 h 30
  timeZone: "Europe/Paris"
  concurrencyPolicy: Forbid        # pas de nouvelle exécution si la précédente tourne encore
  jobTemplate:
    spec:
      backoffLimit: 2              # 2 nouvelles tentatives au maximum en cas d'échec
      template:
        spec:
          restartPolicy: OnFailure
          containers:
            - name: tache
              image: php:8.3-cli
              command: ["php", "-r", "echo 'Rapport généré', PHP_EOL;"]
Chez nous, quand un site migre dans le cluster, ses tâches cron deviennent des CronJobs : créés suspendus, activés au moment de la bascule.
Quand utiliser quoi#
| Objet | apiVersion | Ce qu'il garantit | Exemples |
|---|---|---|---|
| Pod | v1 | Rien : s'il meurt, il n'est pas recréé | Test ponctuel, débogage |
| ReplicaSet | apps/v1 | N copies identiques en permanence | Géré par le Deployment, rarement écrit à la main |
| Deployment | apps/v1 | N copies interchangeables, mises à jour progressives, retour arrière | Sites web, API, applications PHP |
| StatefulSet | apps/v1 | Noms stables, un disque par pod, ordre de démarrage | Bases de données, Redis, registre d'images |
| DaemonSet | apps/v1 | Un pod par nœud | Supervision, journaux, réseau |
| Job | batch/v1 | Une tâche menée à son terme | Migration, import, sauvegarde ponctuelle |
| CronJob | batch/v1 | Un Job à heure fixe | Tâches cron, rapports, nettoyage |
Bon à savoir : notre règle chez Websource tient en quatre lignes. Les applications sont des Deployments. Les données sont des StatefulSets. Les agents qui doivent tourner sur chaque serveur sont des DaemonSets. Les tâches planifiées sont des CronJobs. Si vous hésitez, posez-vous une question : « si je supprime ce pod et qu'il est recréé ailleurs avec un autre nom, est-ce grave ? ». Si la réponse est non, c'est un Deployment.
Les autres mots essentiels#
Service : une adresse stable devant des pods#
Les pods changent d'adresse IP à chaque remplacement. Un Service donne une adresse et un nom DNS stables (par exemple mon-site.demo.svc.cluster.local) à un groupe de pods choisi par selector, et répartit les connexions entre eux. Les principaux types :
- ClusterIP (par défaut) : adresse joignable seulement depuis l'intérieur du cluster ;
- NodePort : ouvre en plus un même port, pris par défaut entre 30000 et 32767, sur chaque nœud ;
- LoadBalancer : demande une adresse publique à un répartiteur de charge externe (fourni par le cloud, ou par ServiceLB dans k3s).
Ingress et Ingress controller : l'entrée HTTP#
Un Ingress est une règle de routage HTTP : « les requêtes pour mon-site.example.com vont au Service mon-site ». L'objet Ingress ne fait rien seul : il faut un Ingress controller, un proxy inverse qui lit ces règles et route réellement le trafic. Dans k3s, c'est Traefik, installé d'office. Traefik apporte aussi ses middlewares : réessai automatique, limitation de débit, redirections. Pour la répartition de charge en général, lisez notre article sur le load balancing.
ConfigMap et Secret : la configuration hors de l'image#
Une ConfigMap stocke de la configuration non sensible (un php.ini, des variables d'environnement) ; un Secret stocke des données sensibles (mots de passe, clés d'API). Les deux s'injectent dans le pod sous forme de variables d'environnement ou de fichiers. Une même image peut ainsi servir dans plusieurs contextes. Attention : par défaut, un Secret est seulement encodé en base64, pas chiffré ; il faut restreindre qui peut le lire.
Volumes et stockage persistant#
- Un volume est un dossier monté dans un conteneur. Certains sont temporaires (
emptyDir, vidé à la disparition du pod), d'autres pointent vers un dossier du serveur (hostPath) ou vers un stockage durable. - Un PersistentVolume (PV) est un morceau de stockage durable mis à disposition du cluster : disque local, partage réseau, disque cloud.
- Un PersistentVolumeClaim (PVC) est une demande de stockage faite par une application : « il me faut 1 Gio en lecture-écriture ». Kubernetes associe la demande à un PV.
- Une StorageClass décrit une catégorie de stockage et sait créer les PV à la demande. Dans k3s, la classe par défaut s'appelle
local-pathet crée des dossiers sur le disque du nœud.
Requests et limits : réserver et plafonner#
Pour chaque conteneur, on déclare des requests (ce qu'il faut lui réserver ; le scheduler s'en sert pour choisir un nœud qui a la place) et des limits (le plafond). Le processeur se compte en millicœurs : 100m = un dixième de cœur. La mémoire se compte en Mi ou Gi. Un conteneur qui dépasse sa limite mémoire est tué (OOMKilled) puis redémarré ; un conteneur qui dépasse sa limite CPU est seulement ralenti.
Probes : savoir si un conteneur va bien#
- La readiness probe (sonde de disponibilité) répond à « peut-il recevoir du trafic ? ». Tant qu'elle échoue, le pod est retiré du Service, sans être redémarré.
- La liveness probe (sonde de vie) répond à « est-il bloqué ? ». Si elle échoue plusieurs fois de suite, le kubelet redémarre le conteneur.
- La startup probe (sonde de démarrage) protège les applications lentes à démarrer : les deux autres sondes n'agissent qu'une fois qu'elle a réussi.
Rolling update et rollback#
Le rolling update remplace les pods par vagues. Deux réglages le pilotent : maxSurge (combien de pods en plus on peut créer pendant la mise à jour) et maxUnavailable (combien de pods peuvent manquer). Le rollback revient à la version précédente enregistrée dans l'historique du Deployment.
PodDisruptionBudget#
Un PodDisruptionBudget (PDB, « budget de perturbation ») fixe combien de pods d'une application doivent rester disponibles pendant les interruptions volontaires : vidage d'un nœud pour maintenance (kubectl drain), mise à jour du cluster. Il ne protège pas contre une panne.
HPA : l'autoscaling horizontal#
Le HorizontalPodAutoscaler (HPA) ajoute ou retire des réplicas selon une mesure, le plus souvent l'utilisation du processeur. Point clé : ce pourcentage est calculé par rapport aux requests, pas par rapport à la puissance du serveur. Le HPA a besoin de metrics-server, inclus dans k3s.
Mise en œuvre pas à pas avec k3s#
1. Installer k3s#
Sur un serveur Linux, la documentation officielle (docs.k3s.io) propose un script d'installation :
# Installe k3s comme service systemd (nœud « server ») ; lisez le script avant si vous le souhaitez
curl -sfL https://get.k3s.io | sh -

# Vérifie que le nœud est prêt (k3s installe kubectl et le configure)
sudo kubectl get nodes

# Le fichier de connexion se trouve ici ; copiez-le dans ~/.kube/config pour un usage sans sudo
sudo cat /etc/rancher/k3s/k3s.yaml
Pour ajouter un second serveur comme agent, récupérez le jeton du server puis lancez le script sur la nouvelle machine :
# Sur le server : affiche le jeton d'inscription
sudo cat /var/lib/rancher/k3s/server/node-token

# Sur la nouvelle machine : rejoint le cluster en tant qu'agent
curl -sfL https://get.k3s.io | K3S_URL=https://ADRESSE_DU_SERVER:6443 K3S_TOKEN=LE_JETON sh -
Le port 6443 de l'API server ne doit être joignable que par les nœuds du cluster et vos postes d'administration : filtrez-le avec votre pare-feu.
2. Décrire l'application : Deployment, Service et Ingress#
Voici un fichier mon-site.yaml complet pour une application PHP servie par Apache, avec deux réplicas, des probes, des requests et limits, et une mise à jour sans perte de capacité :
apiVersion: v1
kind: Namespace
metadata:
name: demo
apiVersion: apps/v1
kind: Deployment
metadata:
name: mon-site
namespace: demo
labels:
app: mon-site
spec:
replicas: 2 # deux copies du pod
selector:
matchLabels:
app: mon-site # les pods gérés sont ceux qui portent ce label
strategy:
type: RollingUpdate
rollingUpdate:
maxUnavailable: 0 # ne jamais descendre sous 2 pods prêts
maxSurge: 1 # créer 1 pod de plus pendant la mise à jour
template: # modèle des pods à créer
metadata:
labels:
app: mon-site
spec:
terminationGracePeriodSeconds: 40
containers:
- name: web
image: php:8.3-apache # en pratique : l'image de votre site
ports:
- containerPort: 80
lifecycle:
preStop:
exec:
command: ["sleep", "10"] # laisse le temps de retirer le pod du routage
resources:
requests:
cpu: 100m # 0,1 cœur réservé
memory: 128Mi
limits:
memory: 512Mi # au-delà, le conteneur est tué (OOMKilled)
readinessProbe: # prêt à recevoir du trafic ?
httpGet:
path: /
port: 80
periodSeconds: 10
livenessProbe: # toujours vivant ?
tcpSocket:
port: 80
initialDelaySeconds: 20
periodSeconds: 20
apiVersion: v1
kind: Service
metadata:
name: mon-site
namespace: demo
spec:
type: ClusterIP
selector:
app: mon-site
ports:
- port: 80
targetPort: 80
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
name: mon-site
namespace: demo
spec:
ingressClassName: traefik # l'Ingress controller fourni par k3s
rules:
- host: mon-site.example.com
http:
paths:
- path: /
pathType: Prefix
backend:
service:
name: mon-site
port:
number: 80Les trois objets sont reliés par le label app: mon-site et par les noms : l'Ingress envoie vers le Service mon-site, qui envoie vers les pods étiquetés app: mon-site, créés par le Deployment. Le preStop retarde l'arrêt d'Apache de 10 secondes : pendant ce temps, le pod est retiré du routage et les requêtes en cours se terminent. terminationGracePeriodSeconds doit rester plus long que cette pause.
3. Appliquer et observer#
# Vérifie le fichier sans rien créer
kubectl apply --dry-run=client -f mon-site.yaml

# Crée (ou met à jour) les objets décrits
kubectl apply -f mon-site.yaml

# Liste les pods du namespace, avec leur nœud et leur adresse IP
kubectl get pods -n demo -o wide

# Vue d'ensemble : Deployment, ReplicaSet, pods, Service
kubectl get all -n demo

# Détail d'un pod et ses événements (image introuvable, probe en échec, manque de place…)
kubectl describe pod -n demo NOM_DU_POD

# Journaux d'un des pods du Deployment, en continu
kubectl logs -n demo deploy/mon-site -f

# Ouvre un terminal dans un des pods
kubectl exec -it -n demo deploy/mon-site -- bash

# Teste le routage sans modifier le DNS (en local sur un nœud k3s)
curl -H 'Host: mon-site.example.com' http://127.0.0.1/
La rubrique Events en bas de kubectl describe est le premier endroit à lire quand un pod reste en Pending, en CrashLoopBackOff (il démarre puis plante en boucle) ou en ImagePullBackOff (image introuvable).
4. Mettre à jour, revenir en arrière, changer d'échelle#
# Change l'image du conteneur « web » : déclenche un rolling update
kubectl set image -n demo deployment/mon-site web=php:8.4-apache

# Suit la mise à jour jusqu'à la fin (ou l'échec)
kubectl rollout status -n demo deployment/mon-site

# Liste les versions enregistrées
kubectl rollout history -n demo deployment/mon-site

# Revient à la version précédente
kubectl rollout undo -n demo deployment/mon-site

# Passe manuellement à 3 réplicas
kubectl scale -n demo deployment/mon-site --replicas=3

# Consommation réelle des pods (grâce à metrics-server)
kubectl top pods -n demo
Si vous gardez vos manifests dans Git, préférez modifier le fichier puis relancer kubectl apply : le fichier reste la référence. C'est la base d'une chaîne de déploiement automatisée, que nous détaillons dans l'article CI/CD : l'intégration et le déploiement continus expliqués.
5. Protéger et faire grandir : PDB et HPA#
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
name: mon-site
namespace: demo
spec:
minAvailable: 1 # au moins 1 pod doit rester disponible
selector:
matchLabels:
app: mon-site
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: mon-site
namespace: demo
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: mon-site
minReplicas: 2
maxReplicas: 4
metrics:
- type: Resource
resource:
name: cpu
target:
type: Utilization
averageUtilization: 70 # % des requests CPU, pas de la machine
behavior:
scaleUp:
policies:
- type: Pods
value: 1 # +1 pod au maximum…
periodSeconds: 60 # …par minute
scaleDown:
stabilizationWindowSeconds: 300 # attendre 5 min avant de réduire# Applique le PDB et le HPA
kubectl apply -f protection.yaml
# Affiche l'utilisation mesurée, la cible et le nombre de réplicas
kubectl get hpa -n demo
# Vide un nœud avant maintenance, en respectant les PDB
kubectl drain NOM_DU_NOEUD --ignore-daemonsets --delete-emptydir-data
# Remet le nœud en service
kubectl uncordon NOM_DU_NOEUDAvec ces réglages, le HPA ajoute au plus un pod par minute quand l'utilisation moyenne dépasse 70 % des requests CPU, et attend cinq minutes de calme avant de réduire. Une fois le HPA en place, ne fixez plus replicas à la main : c'est lui qui décide, entre minReplicas et maxReplicas.
Retour d'expérience : ce que nous avons appris chez Websource#
Le 6 novembre 2026, nous avons migré nos hébergements vers un cluster k3s sur nos deux serveurs dédiés. Quelques enseignements concrets.
Migrer site par site, sans coupure#
Nous n'avons changé aucun DNS. Le serveur web de chaque machine garde les certificats HTTPS et relaie les requêtes vers Traefik, qui les envoie aux pods. On bascule un site à la fois : on construit son image, on compare ses pages servies par le cluster avec la version en production, puis on change une ligne de configuration. Le retour arrière est tout aussi rapide. Chaque site a sa propre image Docker ; les fichiers des clients restent sur le serveur et sont montés dans le conteneur, pour que FTP, l'espace client, les sauvegardes et les quotas continuent de fonctionner. Désormais, quand un client commande un hébergement web, son conteneur est construit et déployé automatiquement, en 25 secondes environ.
Zéro erreur pendant les mises à jour#
Un rolling update « par défaut » laisse passer quelques erreurs 502 : un pod qui s'arrête peut encore recevoir une requête pendant quelques instants. Nous avons combiné trois réglages : 2 réplicas par site client, une pause preStop de 10 secondes et le middleware de réessai de Traefik, qui renvoie la requête vers un autre pod si la connexion échoue. Résultat mesuré : 0 erreur sur 12 520 requêtes envoyées pendant les mises à jour. Les sessions PHP sont stockées dans Redis (Valkey) pour que tous les pods d'un site les partagent : un visiteur garde son panier ou sa connexion quel que soit le pod qui lui répond.
L'autoscaling, mesuré#
Seize sites ont un HPA (minimum 2 pods, maximum 3 ou 4, un pod de plus par minute au plus, descente lente). Lors d'un test de charge sur un site de test réglé à 1 pod minimum (nos sites clients en ont 2), le site est passé de 1 à 2 pods en 50 secondes environ, de 2 à 3 en 85 secondes environ, puis il est redescendu en une dizaine de minutes ; les 1 641 requêtes du test ont toutes reçu une réponse 200.
Trois pièges à éviter#
- Un PDB
minAvailable: 1sur une application à 1 seul réplica bloquekubectl drain. Le seul pod ne peut jamais être évincé sans violer le budget, et le vidage du nœud attend indéfiniment. Passez à 2 réplicas, ou utilisezmaxUnavailable: 1pour ces applications. - Un HPA posé avant d'ajuster les requests monte tout de suite au maximum. Si les requests CPU sont trop basses, la consommation normale représente déjà plusieurs centaines de pour cent des requests. Mesurez d'abord la consommation réelle (
kubectl top pods), fixez les requests en conséquence, puis seulement ajoutez le HPA. - Un pod éloigné de sa base de données peut être beaucoup plus lent. Nous avons essayé des pods de renfort sur l'autre serveur, avec un stockage partagé. Chaque requête SQL y prenait environ 2,5 ms au lieu de 0,03 ms. Une page PrestaShop qui fait 350 à 1 200 requêtes SQL devenait 5 à 20 fois plus lente. Ces renforts ne servent donc qu'aux sites qui font peu de requêtes SQL ou qui sont bien mis en cache. Pour le reste, il vaut mieux garder les pods sur le nœud qui héberge la base (
nodeSelectorou affinité de nœud).
Pour voir comment Docker et Kubernetes se complètent au quotidien, et comment nous surveillons tout cela avec Prometheus et Grafana, lisez Docker et Kubernetes ensemble : héberger, monter en charge et superviser.
Glossaire Docker et Kubernetes#
| Terme | Ce que c'est |
|---|---|
| Cluster | Ensemble de serveurs gérés ensemble par Kubernetes. |
| Nœud (node) | Un serveur du cluster, physique ou virtuel. |
| Control plane | Composants qui pilotent le cluster : API server, etcd, scheduler, controller manager. |
| API server | Porte d'entrée unique du cluster, à qui s'adressent kubectl et tous les composants. |
| etcd | Base clé-valeur qui conserve l'état du cluster. |
| Scheduler | Composant qui choisit le nœud de chaque nouveau pod. |
| Controller manager | Composant qui fait tourner les boucles de contrôle et corrige les écarts entre état voulu et état réel. |
| Kubelet | Agent présent sur chaque nœud, qui démarre et surveille les pods. |
| Container runtime | Logiciel qui lance réellement les conteneurs (containerd, par exemple). |
| k3s | Distribution Kubernetes légère, livrée en un seul binaire. |
| kubectl | Outil en ligne de commande pour piloter un cluster. |
| Manifest | Fichier YAML qui décrit un objet et son état voulu. |
| Namespace | Espace logique qui regroupe et isole des objets. |
| Label / selector | Étiquette clé-valeur posée sur un objet / filtre qui retrouve les objets par leurs étiquettes. |
| Pod | Plus petite unité déployable : un ou plusieurs conteneurs partageant réseau et volumes. |
| Init container | Conteneur qui s'exécute jusqu'au bout avant les conteneurs principaux du pod. |
| Sidecar | Conteneur auxiliaire qui tourne à côté du conteneur principal pendant toute la vie du pod. |
| ReplicaSet | Objet qui maintient N copies identiques d'un pod. |
| Deployment | Objet qui gère des pods interchangeables, avec mises à jour progressives et retour arrière. |
| StatefulSet | Objet qui gère des pods à noms stables, chacun avec son propre stockage. |
| DaemonSet | Objet qui fait tourner un pod sur chaque nœud. |
| Job / CronJob | Tâche menée à son terme / tâche lancée à heure fixe. |
| Service | Adresse et nom DNS stables devant un groupe de pods (ClusterIP, NodePort, LoadBalancer). |
| Ingress / Ingress controller | Règle de routage HTTP / proxy qui applique ces règles (Traefik dans k3s). |
| ConfigMap / Secret | Configuration non sensible / données sensibles injectées dans les pods. |
| PV / PVC / StorageClass | Stockage durable / demande de stockage d'une application / catégorie de stockage qui crée les PV à la demande. |
| Requests / limits | Ressources réservées / plafond de ressources d'un conteneur. |
| Probe | Sonde de santé : readiness (prêt ?), liveness (vivant ?), startup (démarré ?). |
| Rolling update / rollback | Mise à jour progressive des pods / retour à la version précédente. |
| PodDisruptionBudget | Nombre minimal de pods à garder pendant les interruptions volontaires. |
| HPA | HorizontalPodAutoscaler : ajuste le nombre de réplicas selon une mesure. |
Questions fréquentes#
Quelle est la différence entre Docker et Kubernetes ?#
Docker construit des images et lance des conteneurs sur une machine. Kubernetes orchestre des conteneurs sur un groupe de machines : il choisit où les placer, les remplace s'ils tombent, les met à jour progressivement et ajuste leur nombre selon la charge. Les deux sont complémentaires : les images construites avec Docker tournent dans Kubernetes.
Quelle est la différence entre un pod et un conteneur ?#
Un conteneur est un processus isolé lancé à partir d'une image. Un pod est l'enveloppe que Kubernetes déploie : il contient un ou plusieurs conteneurs qui partagent la même adresse IP et peuvent partager des volumes. Le plus souvent, un pod contient un seul conteneur, parfois accompagné d'un init container ou d'un sidecar.
Faut-il choisir un Deployment ou un StatefulSet ?#
Si les pods sont interchangeables et que les données sont stockées ailleurs, comme pour un site web ou une API, choisissez un Deployment. Si chaque pod a besoin d'un nom stable et de son propre disque, comme une base de données ou Redis, choisissez un StatefulSet.
k3s, est-ce du vrai Kubernetes ?#
Oui. k3s est une distribution Kubernetes certifiée, projet de la CNCF, qui accepte les mêmes manifests et la même commande kubectl. Elle est plus légère à installer car livrée en un seul binaire avec containerd, Traefik, CoreDNS, un stockage local et metrics-server déjà inclus.
Pourquoi mon pod reste-t-il en CrashLoopBackOff ?#
Le conteneur démarre puis s'arrête en boucle. Lisez ses journaux avec kubectl logs (ajoutez --previous pour voir ceux de l'exécution précédente) et les événements avec kubectl describe pod. Les causes fréquentes sont une erreur de configuration, une variable ou un fichier manquant, une limite mémoire trop basse (OOMKilled) ou une liveness probe trop sévère.
Article publié le 06/11/2026 sous la signature de Jonathan Gutierrez, rédigé à partir des sources citées ci-dessus, puis relu avant publication. Une information vous semble inexacte ou datée ? Signalez-le nous, nous corrigeons.