TL;DRDocker fabrique le conteneur, Kubernetes le fait tourner, le répare et le multiplie quand la charge monte. Voici comment les deux s'articulent pour héberger des sites web, ce que nous avons appris en migrant les hébergements Websource, et comment superviser le tout avec Prometheus, Grafana et VictoriaMetrics, captures d'écran et requêtes PromQL commentées à l'appui.
Docker et Kubernetes : deux outils, deux rôles#
On oppose souvent Docker et Kubernetes, comme s'il fallait choisir. En réalité, ils ne font pas le même travail et se complètent.
- Docker emballe. Il fabrique une image : un paquet qui contient l'application, son langage (PHP par exemple), ses bibliothèques et sa configuration. Lancée, cette image devient un conteneur, un processus isolé qui tourne de la même façon sur n'importe quel serveur. Nous détaillons tout cela dans l'article Docker : comprendre les conteneurs, les images et le Dockerfile avant Kubernetes.
- Kubernetes fait tourner. C'est un orchestrateur : il décide sur quel serveur lancer chaque conteneur, le relance s'il tombe, répartit le trafic entre plusieurs copies, remplace les anciennes versions par les nouvelles sans coupure et ajoute des copies quand la charge monte. Les bases sont dans l'article Kubernetes : pods, Deployments, StatefulSets et DaemonSets pour orchestrer vos conteneurs Docker.
Docker seul sait lancer un conteneur sur une machine. Mais si la machine redémarre, si le conteneur plante à 3 heures du matin ou si un site reçoit dix fois plus de visites que d'habitude, personne ne réagit. Kubernetes surveille en permanence l'état souhaité (« je veux 2 copies de ce site, prêtes à répondre ») et corrige tout écart avec l'état réel.
| Besoin | Docker | Kubernetes |
|---|---|---|
| Emballer une application et ses dépendances | Oui (image, Dockerfile) | Non, il utilise les images existantes |
| Lancer un conteneur sur un serveur | Oui | Oui, sur n'importe quel serveur du cluster |
| Relancer un conteneur qui plante | Partiellement (politique de redémarrage locale) | Oui, et le déplace si le serveur tombe |
| Répartir les visiteurs entre plusieurs copies | Non (outil à ajouter) | Oui (Service, Ingress) |
| Mettre à jour sans coupure | Non | Oui (mise à jour progressive) |
| Ajouter des copies quand la charge monte | Non | Oui (HPA) |
Ce retour d'expérience vient de notre propre chantier : le 6 novembre 2026, nous avons migré les hébergements Websource vers Docker et Kubernetes, site par site, sans coupure, sur nos deux serveurs dédiés. Nous utilisons k3s, une distribution de Kubernetes légère et certifiée, adaptée à un petit nombre de serveurs.
Le parcours d'une requête, d'Internet au conteneur#
Quand un visiteur ouvre une page d'un site hébergé dans Kubernetes, sa requête traverse plusieurs étapes :
- HTTPS : le navigateur se connecte en chiffré. Chez nous, le serveur web de l'hôte garde les certificats et déchiffre la connexion, puis relaie la requête dans le cluster.
- Ingress et Traefik : un Ingress est une règle Kubernetes qui dit « les requêtes pour tel nom de domaine vont vers tel Service ». Le programme qui applique ces règles s'appelle un Ingress controller ; k3s fournit Traefik par défaut.
- Service : un Service est une adresse stable devant un groupe de pods. Les pods naissent et meurent, leur adresse change ; le Service, lui, reste et ne transmet qu'aux pods prêts.
- Pods : un pod est la plus petite unité que Kubernetes fait tourner, un ou plusieurs conteneurs lancés ensemble. Les deux copies d'un site peuvent tourner sur deux serveurs différents : Traefik envoie vers des pods de n'importe quel nœud.
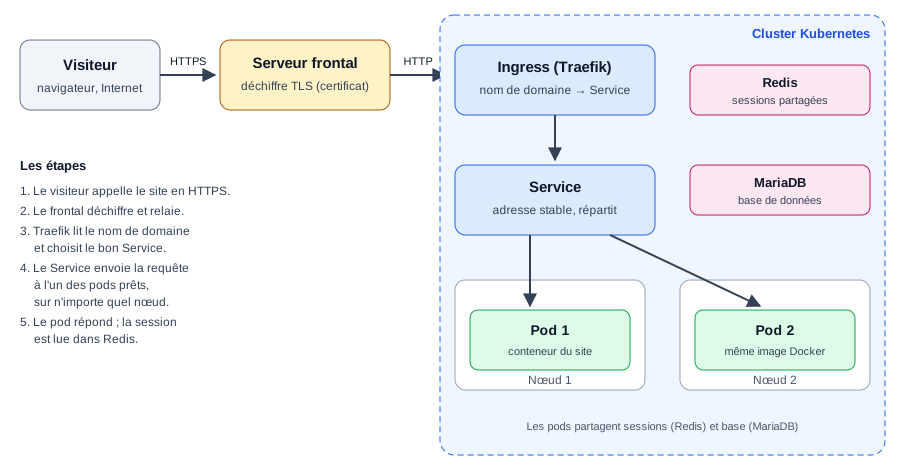
Ce découpage a un avantage concret : nous avons pu basculer chaque site d'un serveur web classique vers le cluster en changeant seulement la destination du relais, sans toucher au DNS. En cas de problème, le retour arrière se fait de la même façon.
Les types d'objets Kubernetes appliqués à un hébergement web#
Kubernetes ne lance pas les conteneurs « à la main » : on lui décrit des objets dans des fichiers YAML (on parle de manifests), et chaque type d'objet correspond à un usage. Voici la règle que nous appliquons, résumée ; l'article Kubernetes détaille chaque type avec ses exemples.
| Objet | Rôle | Chez Websource |
|---|---|---|
| Deployment | Garder N copies identiques et interchangeables d'une application, les mettre à jour progressivement | Chaque site web (2 réplicas par site client) |
| StatefulSet | Applications avec des données : nom stable, disque attitré, démarrage dans l'ordre | Registre d'images privé, réplica MariaDB, Redis des sessions |
| DaemonSet | Exactement un pod sur chaque serveur du cluster | Agents de supervision (node-exporter et exporteurs des services de l'hôte) |
| CronJob | Tâche planifiée, comme une ligne de crontab | Par exemple une tâche SEO d'un site |
| Init container | Conteneur qui s'exécute et se termine avant le conteneur principal | Préparer le réseau des pods de renfort |
| Sidecar | Conteneur secondaire qui tourne à côté du principal, dans le même pod | Un relais vers la base MariaDB à côté du site |
Pour un hébergement, la logique est simple : ce qui sert les pages et peut être recréé à l'identique est un Deployment ; ce qui garde des données est un StatefulSet ; ce qui doit tourner partout est un DaemonSet ; ce qui s'exécute à heure fixe est un CronJob.
Monter en charge : requests, limits et HPA#
Réserver et plafonner : requests et limits#
Chaque conteneur déclare deux valeurs par ressource (processeur et mémoire) :
- la request est ce que Kubernetes réserve pour le conteneur : il ne le place sur un serveur que s'il reste assez de place ;
- la limit est le plafond : au-delà de sa limite mémoire, le conteneur est arrêté (on dit qu'il est « OOMKilled ») ; au-delà de sa limite CPU, il est ralenti.
Le CPU se compte en millicœurs : 250m vaut un quart de cœur. Nous avons calculé ces valeurs à partir des mesures réelles de chaque site. Pour l'un de nos sites, cela donne :
resources:
  requests:
    cpu: 25m        # réservé : 2,5 % d'un cœur, la consommation habituelle mesurée
    memory: 64Mi    # réservé : 64 mébioctets
  limits:
    memory: 3Gi     # plafond mémoire : protège les autres sites du serveur
    # pas de limite CPU : le site peut profiter du processeur libre lors d'un pic
Un piège rencontré : un autoscaler posé avant d'ajuster les requests monte tout de suite au maximum, parce qu'il raisonne par rapport à des valeurs qui ne correspondent pas à la réalité. Mesurez d'abord, réglez ensuite.
L'autoscaling horizontal (HPA)#
Le HorizontalPodAutoscaler (HPA) ajoute ou retire des pods selon une mesure, le plus souvent l'utilisation du processeur. « Horizontal » signifie qu'on ajoute des copies, au lieu de grossir une copie. Chez nous, 16 sites ont un HPA : minimum 2 pods, maximum 3 ou 4 selon le site, montée d'un pod par minute au plus, descente lente. Un HPA simplifié ressemble à ceci :
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: mon-site
  namespace: sites
spec:
  scaleTargetRef:            # ce que l'on fait varier : le Deployment du site
    apiVersion: apps/v1
    kind: Deployment
    name: mon-site
  minReplicas: 2             # jamais moins de 2 pods (mises à jour sans coupure)
  maxReplicas: 3
  metrics:
  - type: ContainerResource  # mesure le conteneur du site seul, pas ses voisins du pod
    containerResource:
      name: cpu
      container: web
      target:
        type: AverageValue
        averageValue: 300m   # au-delà de 0,3 cœur en moyenne par pod : on ajoute un pod
  behavior:
    scaleUp:
      policies: [{type: Pods, value: 1, periodSeconds: 60}]    # +1 pod par minute au plus
    scaleDown:
      stabilizationWindowSeconds: 600                          # attendre 10 min de calme
      policies: [{type: Pods, value: 1, periodSeconds: 300}]   # -1 pod toutes les 5 min
# Appliquer, puis suivre l'autoscaler en direct
kubectl apply -f hpa.yaml
kubectl -n sites get hpa mon-site --watch
# Comprendre une décision (événements, mesure lue, raison)
kubectl -n sites describe hpa mon-site
# Voir la consommation réelle des pods (metrics-server, fourni par k3s)
kubectl -n sites top podsNotre test de charge a été fait sur un site de test réglé à 1 pod minimum (les sites clients ont 2 pods minimum) : le HPA est passé de 1 à 2 pods en 50 secondes environ, puis de 2 à 3 en 85 secondes environ ; les 1 641 requêtes du test ont toutes reçu une réponse 200. Après le test, le site est redescendu en une dizaine de minutes, comme prévu par la descente lente.
Pour que les mises à jour ne coupent rien, trois réglages travaillent ensemble : au moins 2 réplicas, un PodDisruptionBudget (règle qui interdit de retirer tous les pods d'un site à la fois, par exemple lors d'une maintenance), et une courte pause avant l'arrêt de chaque pod (preStop de 10 secondes) combinée à une nouvelle tentative automatique dans Traefik. Résultat mesuré : 0 erreur sur 12 520 requêtes envoyées pendant les mises à jour. Attention toutefois : un PodDisruptionBudget qui exige 1 pod disponible sur un site qui n'a qu'un seul réplica bloque la commande kubectl drain utilisée pour vider un serveur avant maintenance.
Les sessions dans Redis : indispensable dès 2 pods#
Une session PHP garde ce qui identifie un visiteur entre deux pages : connexion à son compte, contenu du panier. Par défaut, PHP l'enregistre dans un fichier sur le disque du serveur. Avec deux pods, la première requête peut arriver sur le pod 1 et la suivante sur le pod 2, qui ne connaît pas ce fichier : le visiteur est déconnecté ou son panier se vide.
La solution : stocker les sessions dans un service commun que tous les pods consultent. Nous utilisons Redis, une base de données en mémoire très rapide, sous la forme de Valkey 8.1 (un projet compatible Redis). Chaque site a son propre utilisateur, limité par des règles d'accès (ACL) à ses propres sessions. Nous avons basculé les sites vers Redis sans faire perdre de session aux visiteurs, en vérifiant qu'un panier créé avant la bascule restait lisible par chacun des pods.
La base de données et la latence : la leçon des pods de renfort#
Ajouter des pods ne sert à rien si tous attendent la même ressource. Nous avons testé des pods de renfort placés sur l'autre serveur, avec les fichiers du site partagés par le réseau. Sur le papier, cela double la capacité. En pratique, chaque requête SQL depuis l'autre serveur prend environ 2,5 ms au lieu de 0,03 ms en local. Une page PrestaShop fait entre 350 et 1 200 requêtes SQL : elle devient 5 à 20 fois plus lente.
La leçon : les renforts éloignés de la base conviennent aux sites qui font peu de requêtes SQL ou qui servent leurs pages depuis un cache ; pour une boutique, il vaut mieux garder le calcul près de la base. Côté données, MariaDB a désormais un réplica (une copie synchronisée en temps réel) dans le cluster, vérifié par sommes de contrôle sur 519 tables ; sa promotion en cas de panne est préparée mais n'a pas encore été faite.
Superviser : Prometheus, Grafana et VictoriaMetrics#
Un cluster qui répare tout seul les pannes peut aussi les masquer : un pod qui redémarre en boucle, un serveur qui manque de mémoire, un site qui répond lentement. La supervision (ou monitoring) consiste à mesurer en continu, à afficher ces mesures et à alerter quand elles sortent des clous.
Prometheus : le principe#
Prometheus est l'outil de référence pour mesurer un cluster Kubernetes. Ses idées clés :
- Le modèle pull : c'est Prometheus qui vient chercher les mesures (on dit qu'il « scrape »), à intervalle régulier, sur une adresse HTTP de chaque cible, en général
/metrics. Les applications n'envoient rien : elles exposent. - Les exporters (exporteurs) : de petits programmes qui traduisent l'état d'un système au format Prometheus.
node-exporterpour le serveur (CPU, mémoire, disques, réseau),mysqld-exporterpour MariaDB,redis_exporterpour Redis,kube-state-metricspour l'état des objets Kubernetes. Traefik expose ses propres mesures. - Les séries temporelles : chaque mesure est une suite de valeurs horodatées. Une série est identifiée par un nom de métrique et des labels (étiquettes clé=valeur).
- PromQL : le langage de requête qui calcule des taux, des moyennes, des percentiles sur ces séries.
- Alertmanager : le composant qui reçoit les alertes, les regroupe, évite les doublons et les envoie (e-mail, messagerie…).
Voici à quoi ressemble une mesure exposée par node-exporter, au format texte de Prometheus :
# HELP node_cpu_seconds_total Seconds the CPUs spent in each mode.
# TYPE node_cpu_seconds_total counter
node_cpu_seconds_total{cpu="0",mode="idle"} 530347.52
Lecture : depuis son démarrage, le cœur n°0 a passé 530 347 secondes inoccupé (mode="idle"). C'est un compteur : il ne fait qu'augmenter. Seule sa vitesse d'augmentation est intéressante, et c'est PromQL qui la calcule avec rate().
Grafana : les tableaux de bord#
Grafana n'enregistre pas les mesures : il les affiche. On lui déclare des sources de données (Prometheus ou un équivalent, mais aussi des bases SQL, des journaux…), puis on compose des tableaux de bord faits de panneaux (courbes, jauges, tableaux), chacun alimenté par une requête PromQL. Des variables en haut du tableau permettent de filtrer (un serveur, un namespace, un site) sans réécrire les requêtes. Grafana sait aussi déclencher des alertes ; nous avons préféré confier les nôtres à la chaîne règles + Alertmanager, indépendante de l'affichage.
Pourquoi VictoriaMetrics plutôt que Prometheus#
Chez nous, la base qui collecte et stocke les mesures n'est pas Prometheus lui-même mais VictoriaMetrics, une base de séries temporelles compatible Prometheus : elle lit le même format d'exposition, accepte la même configuration de collecte, comprend PromQL (son langage MetricsQL en est une extension) et se branche dans Grafana comme une source Prometheus. Son composant vmalert évalue des règles d'alerte au format Prometheus et les transmet au même Alertmanager.
Pourquoi ce choix, qui est courant ? Pour sa légèreté : sa version « single » tient en un seul programme, et sa documentation met en avant une consommation de mémoire et de disque réduite. Sur deux serveurs qui hébergent déjà des sites, chaque mégaoctet compte. Prometheus aurait aussi fait l'affaire : tout ce qui suit (exporters, PromQL, règles, Grafana) s'applique à l'un comme à l'autre.
Notre installation : collecte toutes les 30 secondes, conservation 30 jours, node-exporter en DaemonSet, kube-state-metrics, exporteurs Apache, MariaDB et Redis, mesures de Traefik, et 26 règles d'alerte envoyées par e-mail (mémoire, disque, pod en redémarrage en boucle, erreurs 5xx d'un site, temps de réponse, MariaDB ou Redis arrêtés…).
Nos tableaux de bord, en images#
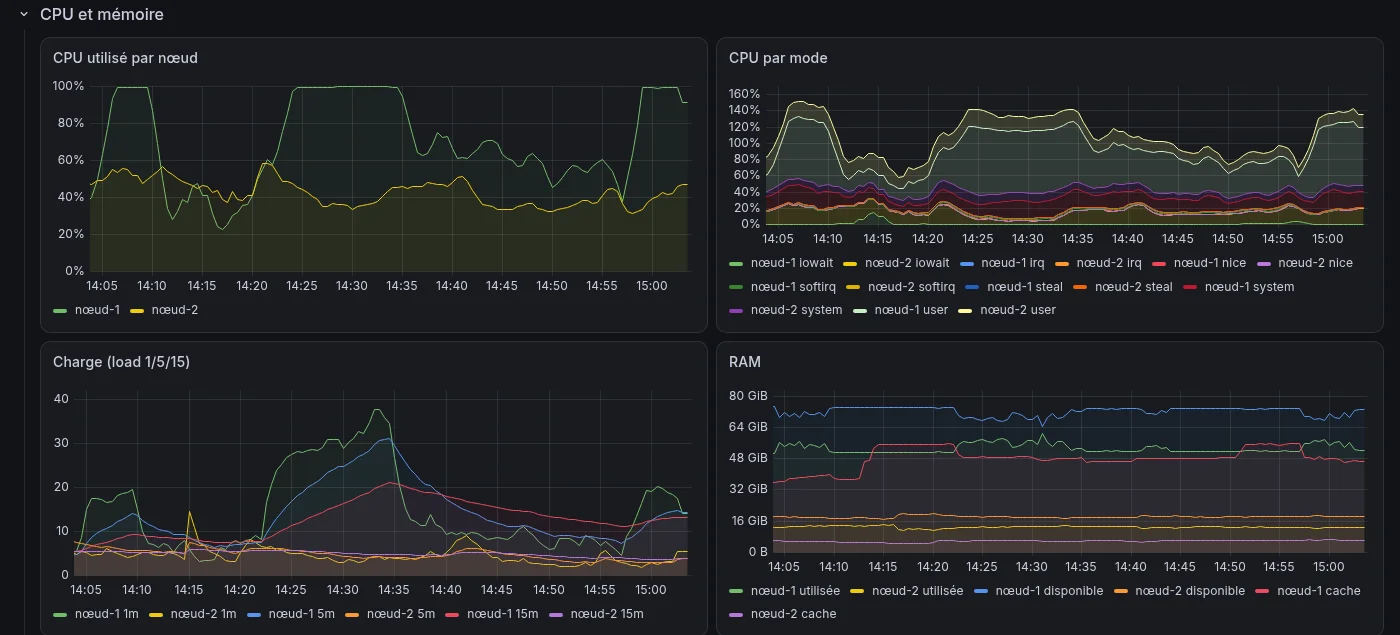
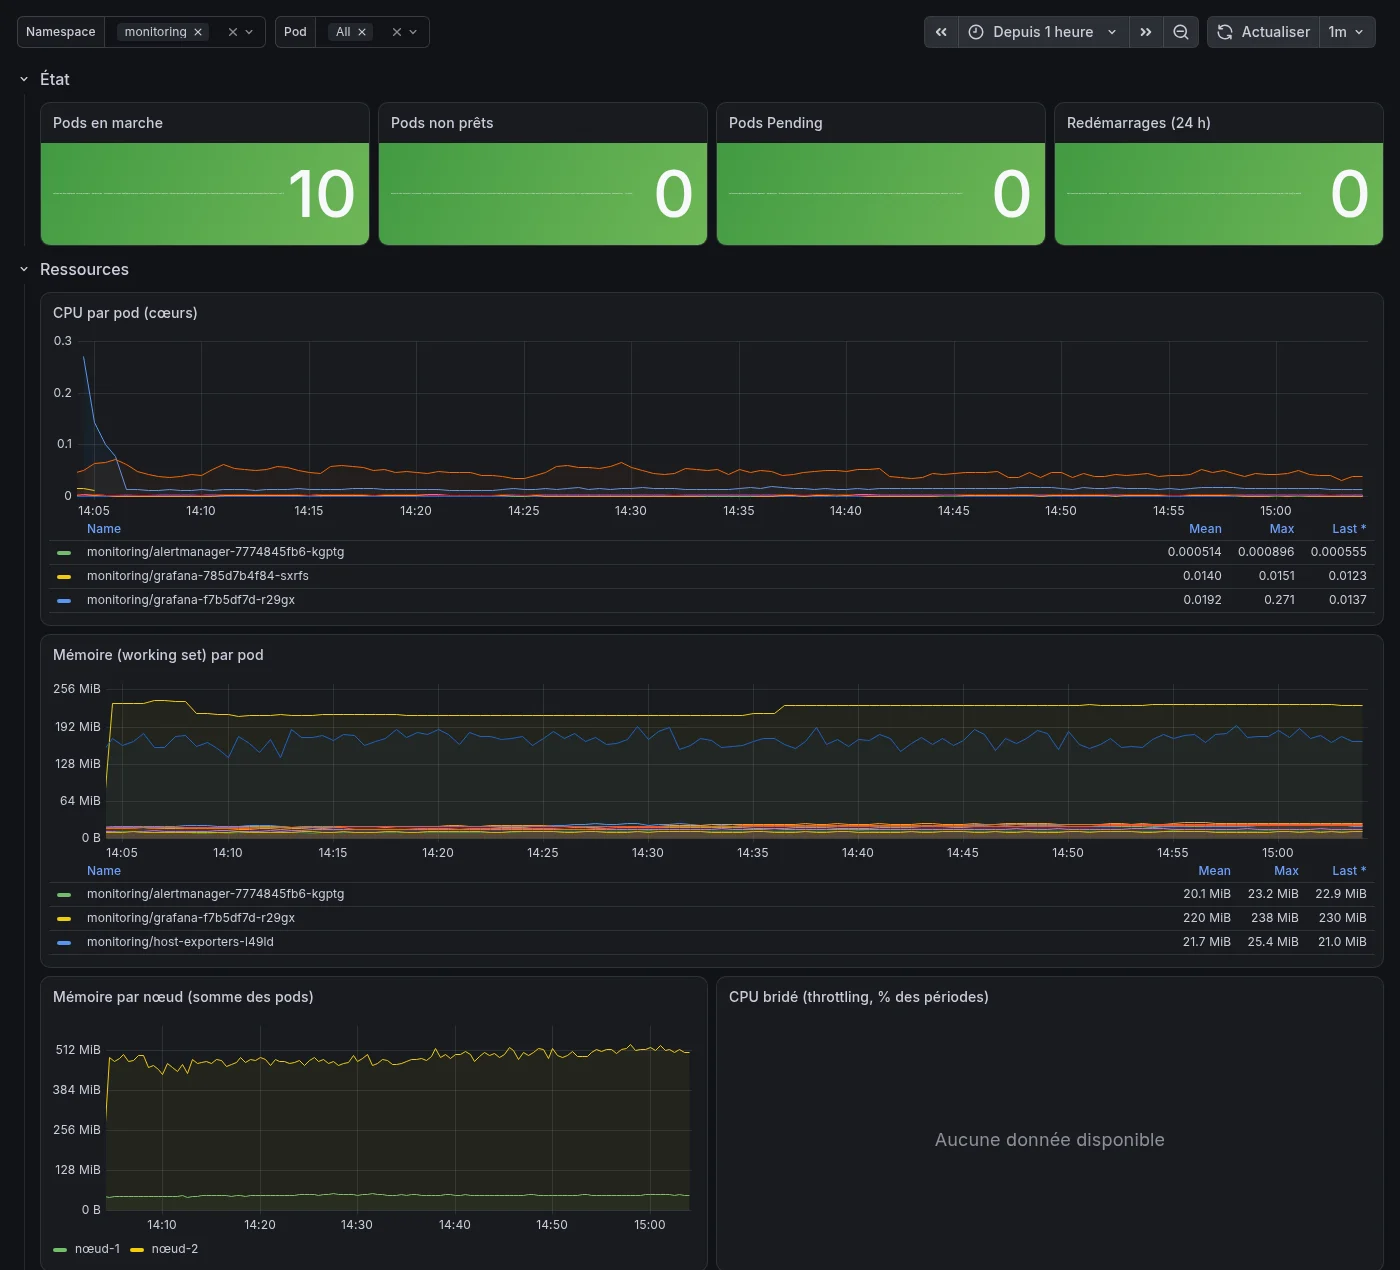
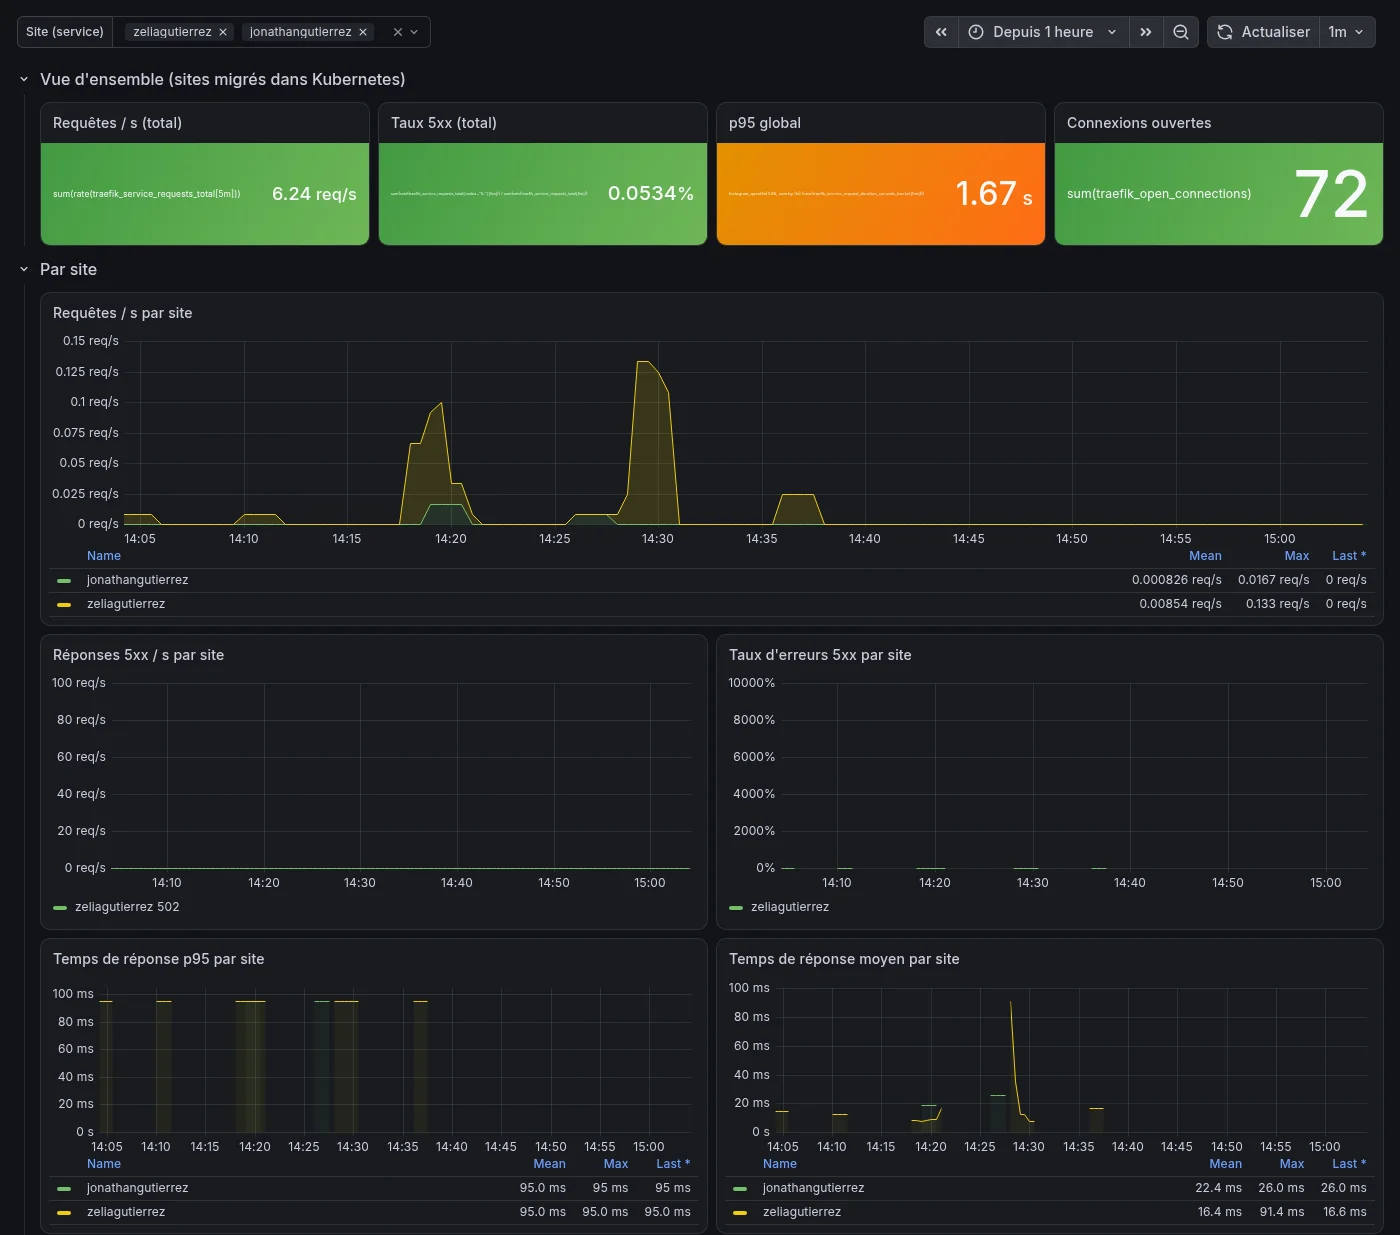
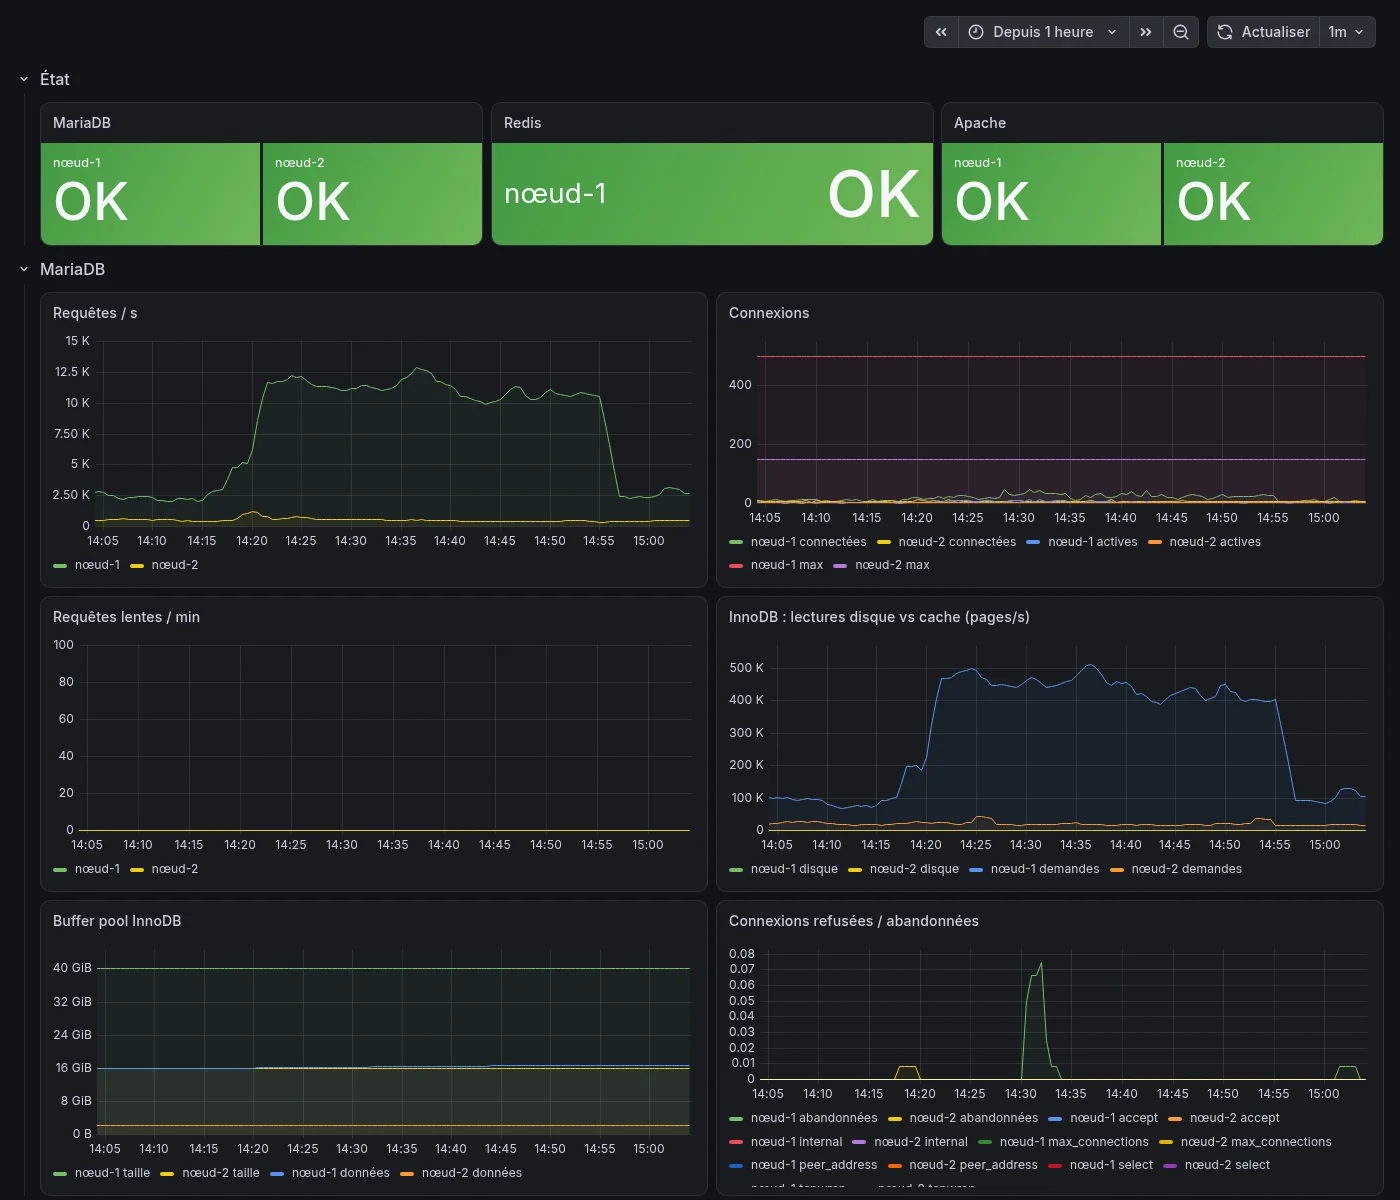
Les captures suivantes viennent de notre Grafana, le 6 novembre 2026 vers 15 h (UTC), sur la dernière heure. Les noms de nos serveurs ont été remplacés par « nœud-1 » et « nœud-2 », et nous n'affichons que des éléments internes ou les sites du fondateur.
PromQL par l'exemple : quatre requêtes commentées#
Ces requêtes sont celles de nos tableaux de bord et de nos alertes. Vous pouvez les tester dans l'onglet Explore de Grafana ou dans l'interface de requêtes de Prometheus (ou vmui pour VictoriaMetrics).
1. Le CPU utilisé par chaque serveur#
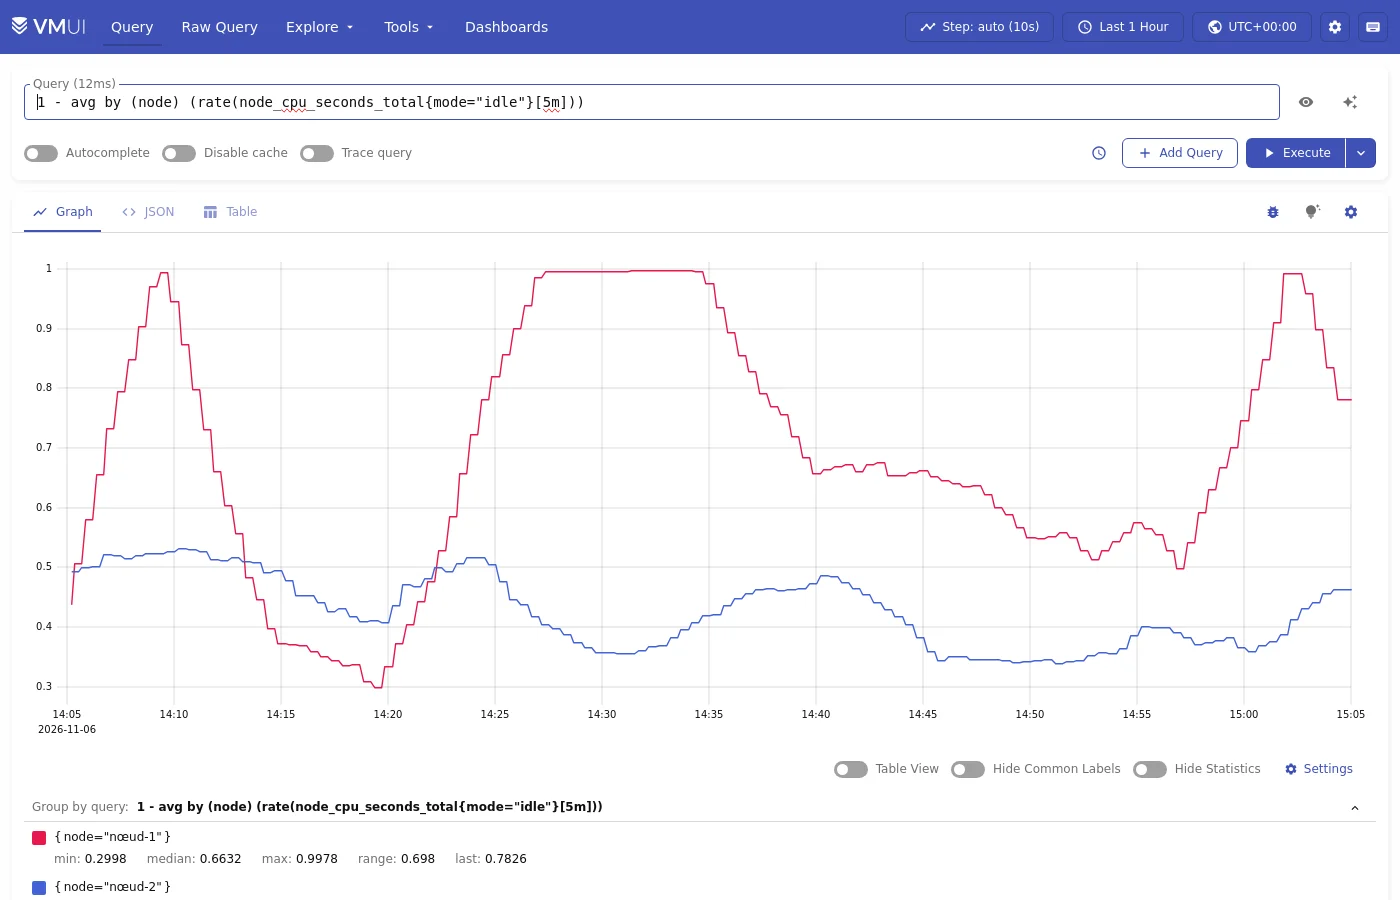
1 - avg by (node) (rate(node_cpu_seconds_total{mode="idle"}[5m]))node_cpu_seconds_total{mode="idle"}: le temps d'inactivité de chaque cœur ;rate(...[5m]): sa vitesse d'augmentation par seconde, en moyenne sur 5 minutes, soit la part de temps inactif (entre 0 et 1) ;avg by (node): la moyenne de tous les cœurs, par serveur (le labelnodeest ajouté par notre configuration de collecte ; sans elle, utilisezinstance) ;1 - ...: on passe du temps inactif au temps utilisé. 0,8 signifie 80 %.
2. La mémoire réellement utilisée par chaque pod#
sum by (pod) (container_memory_working_set_bytes{namespace="monitoring", container!=""})Le working set est la mémoire que le conteneur utilise vraiment, celle que Kubernetes compare à la limite. Le filtre container!="" écarte la ligne qui totalise déjà le pod entier, pour ne pas compter deux fois. Comparez ce chiffre à la request et à la limit du conteneur pour savoir s'ils sont bien réglés.
3. Le taux d'erreurs 5xx par site#
sum by (service) (rate(traefik_service_requests_total{code=~"5.."}[5m]))
  /
sum by (service) (rate(traefik_service_requests_total[5m]))
En haut, les réponses dont le code commence par 5 (erreur côté serveur) ; en bas, toutes les réponses ; le tout par site (service, au sens Traefik). Le résultat est une proportion : 0,05 signifie 5 % d'erreurs. Notre alerte se déclenche au-delà de 5 % pendant 5 minutes, et seulement si le site reçoit un minimum de trafic, pour ignorer une erreur isolée sur un site presque sans visite.
4. Le temps de réponse au 95e percentile (p95)#
histogram_quantile(0.95,
  sum by (le, service) (rate(traefik_service_request_duration_seconds_bucket[5m])))
Le p95 est la durée sous laquelle se trouvent 95 % des requêtes : si le p95 vaut 1 seconde, 5 % des visiteurs attendent plus d'une seconde. C'est plus parlant qu'une moyenne, qui cache les visiteurs les plus mal servis. Traefik range chaque durée dans des « seaux » (_bucket) avec un label le (inférieur ou égal) ; histogram_quantile estime le percentile à partir de ces seaux. Conséquence : le résultat ne peut pas dépasser le plus grand seau défini.
Une alerte qui a tout de suite servi#
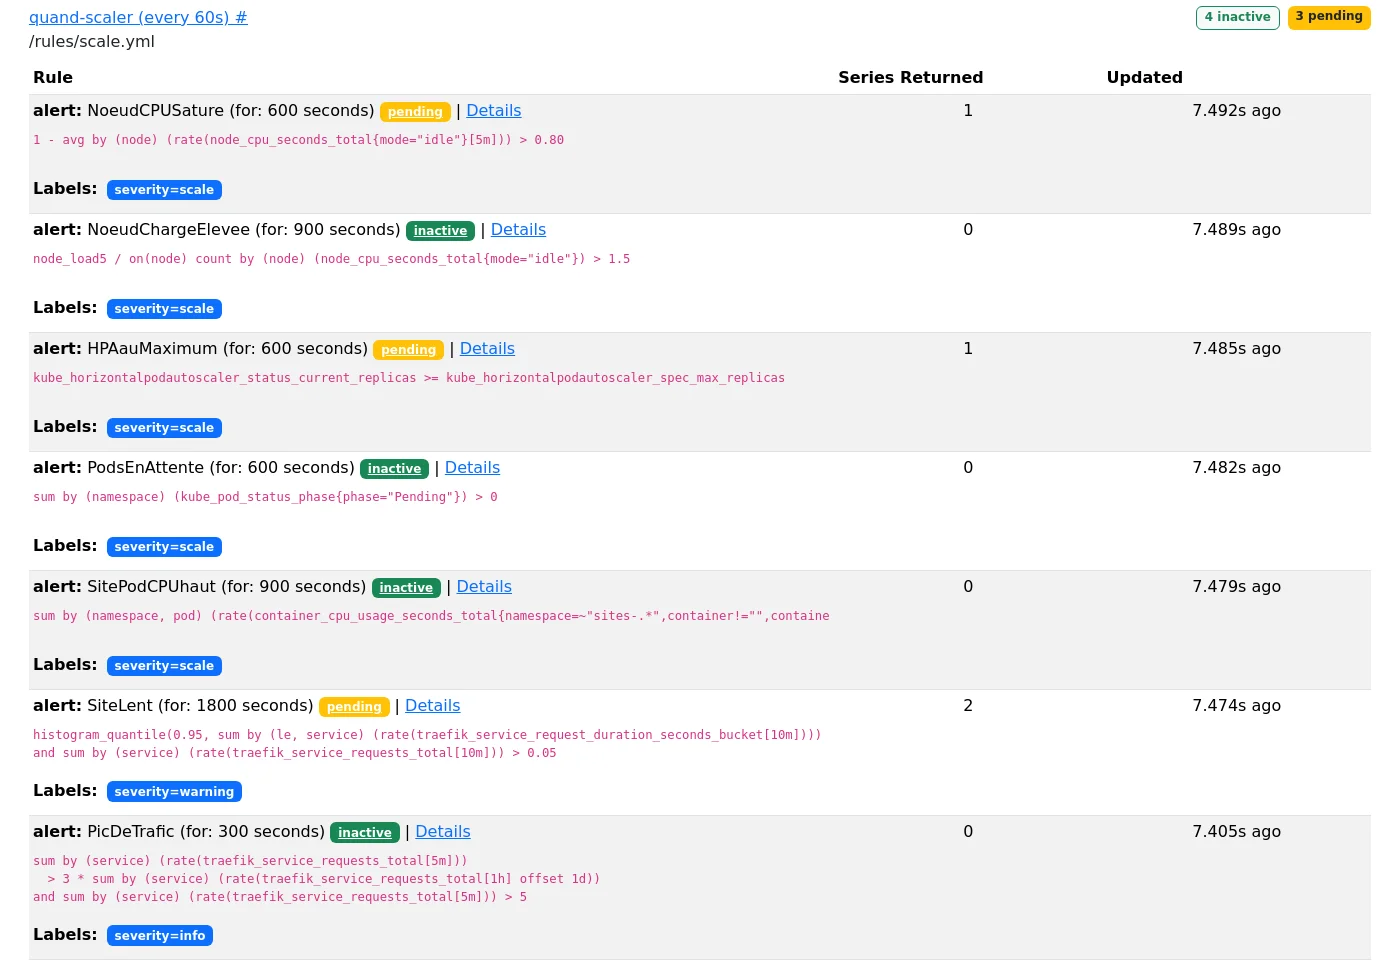
Quelques heures après la mise en place de la supervision, l'alerte « CPU d'un nœud au-dessus de 80 % » s'est déclenchée. Les tableaux de bord ont montré d'où venait la charge : un robot d'indexation envoyait de nombreuses requêtes vers deux sites. Plutôt que de modifier ces sites, nous avons limité ce robot dans Traefik, devant eux : un middleware (un traitement appliqué aux requêtes en transit) de type rateLimit, appliqué seulement aux requêtes dont le User-Agent contient le nom du robot. Au-delà de la limite, le robot reçoit une réponse 429 Too Many Requests (« trop de requêtes »), qui l'invite à ralentir ; les visiteurs, eux, ne passent pas par cette règle.
apiVersion: traefik.io/v1alpha1
kind: Middleware
metadata:
name: robot-ratelimit
namespace: sites
spec:
rateLimit:
average: 1 # 1 requête par seconde en moyenne
period: 1s
burst: 5 # pointe tolérée
sourceCriterion:
requestHeaderName: User-Agent # un seul compteur pour tout le robot
apiVersion: traefik.io/v1alpha1
kind: IngressRoute
metadata:
name: robot-mon-site
namespace: sites
spec:
entryPoints: [web]
routes:
- match: Host(`www.exemple.fr`) && HeaderRegexp(`User-Agent`, `ExempleBot`)
priority: 10000 # passe avant la route normale du site
middlewares: [{name: robot-ratelimit}]
services: [{name: mon-site, port: 80}]C'est l'intérêt d'avoir Docker, Kubernetes et la supervision ensemble : le problème est vu en quelques minutes, compris grâce aux mesures par site, et corrigé à l'entrée du cluster sans toucher au conteneur du site.
Mise en œuvre : installer les briques de supervision#
1. node-exporter en DaemonSet#
node-exporter doit tourner sur chaque serveur : c'est exactement le rôle d'un DaemonSet. Version simplifiée de notre manifest :
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
  namespace: monitoring
spec:
  selector:
    matchLabels: {app: node-exporter}
  template:
    metadata:
      labels: {app: node-exporter}
    spec:
      hostNetwork: true            # utilise le réseau du serveur : voit ses vraies interfaces
      hostPID: true                # voit les processus du serveur
      tolerations: [{operator: Exists}]   # tourne aussi sur les nœuds marqués « réservés »
      containers:
      - name: node-exporter
        image: quay.io/prometheus/node-exporter:v1.12.1
        args:
        - --path.procfs=/host/proc
        - --path.sysfs=/host/sys
        - --path.rootfs=/host/root
        ports: [{name: metrics, containerPort: 9100}]
        resources:
          requests: {cpu: 10m, memory: 24Mi}
          limits: {memory: 64Mi}
        volumeMounts:
        - {name: proc, mountPath: /host/proc, readOnly: true}
        - {name: sys, mountPath: /host/sys, readOnly: true}
        - {name: root, mountPath: /host/root, readOnly: true}
      volumes:                     # dossiers du serveur, montés en lecture seule
      - {name: proc, hostPath: {path: /proc}}
      - {name: sys, hostPath: {path: /sys}}
      - {name: root, hostPath: {path: /}}
Le port 9100 utilisé en hostNetwork est ouvert sur le serveur : filtrez-le dans le pare-feu pour qu'il ne soit pas joignable depuis Internet.
2. Dire au collecteur où trouver les mesures#
Prometheus comme VictoriaMetrics lisent une configuration de collecte au même format. Ici, la liste des serveurs vient directement de l'API Kubernetes (kubernetes_sd_configs), et l'on remplace le port par celui de node-exporter :
global:
  scrape_interval: 30s           # une mesure toutes les 30 secondes
scrape_configs:
- job_name: node
  kubernetes_sd_configs:
  - role: node                   # une cible par nœud du cluster
  relabel_configs:
  - source_labels: [__address__]
    regex: '(.*):\d+'
    replacement: '${1}:9100'     # adresse du nœud, port de node-exporter
target_label: __address__3. Une règle d'alerte#
Une règle d'alerte est une requête PromQL avec une condition, une durée et un message. Celle qui a révélé le robot :
groups:
- name: quand-scaler
interval: 1m # évaluée chaque minute
rules:
- alert: NoeudCPUSature
expr: 1 - avg by (node) (rate(node_cpu_seconds_total{mode="idle"}[5m])) > 0.80
for: 10m # doit rester vraie 10 minutes : ignore les pics brefs
labels:
severity: scale # sert à Alertmanager pour choisir le destinataire
annotations:
summary: "CPU $labels.node > 80 % depuis 10 min"Une alerte passe par trois états : inactive (condition fausse), pending (condition vraie, mais pas encore depuis la durée for) et firing (déclenchée, transmise à Alertmanager).
4. Appliquer et vérifier avec kubectl#
# Créer le namespace puis appliquer les manifests du dossier
kubectl create namespace monitoring
kubectl apply -f supervision/

# Le DaemonSet doit afficher autant de pods prêts que de nœuds
kubectl -n monitoring get daemonset node-exporter
kubectl -n monitoring get pods -o wide        # -o wide : affiche le nœud de chaque pod

# En cas de souci : événements et journaux
kubectl -n monitoring describe pod <nom-du-pod>
kubectl -n monitoring logs daemonset/node-exporter

# Après une modification du manifest : suivre la mise à jour progressive
kubectl -n monitoring rollout status daemonset/node-exporter5. Ouvrir Grafana sans l'exposer sur Internet#
Un tableau de bord de supervision révèle beaucoup de choses sur votre infrastructure : ne le publiez pas. Gardez le Service de Grafana interne au cluster et accédez-y par un tunnel SSH, qui fait passer la connexion par votre accès SSH chiffré.
# Sur le serveur : relayer le Service Grafana vers le port local 3000 du serveur
kubectl -n monitoring port-forward svc/grafana 3000:80

# Sur votre poste : relier votre port 3000 à celui du serveur, à travers SSH
ssh -N -L 3000:127.0.0.1:3000 utilisateur@votre-serveur

# Puis ouvrez http://127.0.0.1:3000 dans votre navigateur
Si kubectl est installé sur votre poste avec l'accès au cluster, la première commande suffit, lancée en local. L'option -N de SSH ouvre le tunnel sans lancer de terminal distant ; -L définit la redirection de port.
Chez Websource : un conteneur Docker pour chaque hébergement, dès la commande. Chaque hébergement web reçoit systématiquement son propre conteneur Docker, orchestré par Kubernetes. Quand vous commandez, votre compte est créé puis, en arrière-plan, votre conteneur est construit et déployé, en 25 secondes environ. Il part d'une image PHP par version, avec le php.ini et les extensions de votre hébergement ; si vous changez de version de PHP ou de réglage dans l'espace client, le conteneur suit. Vos fichiers restent accessibles comme avant (FTP, espace client, sauvegardes), et l'installation en un clic de WordPress ou PrestaShop fonctionne dans ce conteneur. Si la mise en conteneur échouait, votre site resterait servi de façon classique, sans coupure.
Ce que cela vous apporte : un environnement d'exécution identique et reproductible, des mises à jour sans coupure grâce aux deux réplicas, et une supervision de chaque site. C'est aussi une bonne base pour une démarche CI/CD : Websource ne fournit pas de pipeline Git hébergé, mais le dépôt d'un site se fait par l'API et le serveur MCP Websource (préparer un dépôt, envoyer l'archive ou le dump par
curl, suivre le dépôt), donc il se scripte depuis GitHub Actions ou GitLab CI. Découvrez nos offres d'hébergement web et leur section « Notre infrastructure ».
Les pièges que nous avons rencontrés#
- Les images PHP officielles n'ont pas de php.ini : partez de
php.ini-production, fourni dans l'image, sinon PHP tourne avec ses valeurs par défaut. - Gardez le même chemin que sur le serveur d'origine : certains CMS enregistrent des chemins absolus dans leur configuration ou leur base.
- Les .htaccess avec
php_admin_*étaient ignorés sous PHP-FPM mais provoquent une erreur 500 sous mod_php dans le conteneur : à remplacer avant de basculer. - PodDisruptionBudget et site à un seul réplica : bloque
kubectl drain. - HPA avant les requests : l'autoscaler monte tout de suite au maximum.
Glossaire Docker et Kubernetes#
| Terme | Définition |
|---|---|
| Image | Paquet figé contenant une application et tout ce qu'il lui faut pour tourner. Fabriquée par Docker à partir d'un Dockerfile. |
| Conteneur | Une image en cours d'exécution, isolée du reste du serveur. |
| Orchestrateur | Logiciel qui place, relance, répartit et met à jour des conteneurs sur plusieurs serveurs. Kubernetes en est un. |
| Cluster, nœud | Le cluster est l'ensemble des serveurs gérés par Kubernetes ; chaque serveur est un nœud. |
| Pod | Plus petite unité lancée par Kubernetes : un ou plusieurs conteneurs qui partagent le réseau. |
| Deployment, StatefulSet, DaemonSet, CronJob | Types d'objets Kubernetes : application interchangeable, application avec données, un pod par nœud, tâche planifiée. |
| Init container, sidecar | Conteneur qui prépare le pod avant le démarrage du principal ; conteneur auxiliaire qui tourne à côté du principal. |
| Service | Adresse stable devant un groupe de pods, qui répartit les requêtes entre les pods prêts. |
| Ingress, Ingress controller | Règle d'entrée HTTP (nom de domaine vers Service) et programme qui l'applique (Traefik dans k3s). |
| Middleware | Traitement appliqué par Traefik aux requêtes en transit : limite de débit, nouvelle tentative, en-têtes… |
| Request, limit | Ressources réservées pour un conteneur ; plafond qu'il ne peut pas dépasser. |
| HPA | HorizontalPodAutoscaler : ajoute ou retire des pods selon une mesure comme le CPU. |
| PodDisruptionBudget | Règle qui garantit un nombre minimal de pods disponibles pendant une maintenance. |
| Session | Données d'un visiteur conservées entre deux pages (connexion, panier). |
| Redis | Base de données en mémoire, utilisée ici pour partager les sessions entre pods. |
| Réplica (base de données) | Copie d'une base synchronisée en continu avec la base principale. |
| Supervision (monitoring) | Mesure continue de l'état des serveurs et des applications, avec affichage et alertes. |
| Prometheus | Outil open source de collecte de mesures et d'alerte, fondé sur le modèle pull. |
| Modèle pull, scrape | Le collecteur vient chercher les mesures sur chaque cible ; chaque collecte s'appelle un scrape. |
| Exporter | Programme qui traduit l'état d'un système (serveur, MariaDB, Redis) au format Prometheus. |
| Série temporelle | Suite de valeurs horodatées, identifiée par un nom de métrique et des labels. |
| Label | Étiquette clé=valeur qui précise une série : serveur, site, code HTTP… |
| PromQL | Langage de requête de Prometheus, compris aussi par VictoriaMetrics. |
| p95 (95e percentile) | Valeur sous laquelle se trouvent 95 % des mesures, ici des temps de réponse. |
| Alertmanager | Composant qui regroupe, dédoublonne et envoie les alertes. |
| VictoriaMetrics, vmalert, vmui | Base de séries temporelles compatible Prometheus ; son moteur de règles d'alerte ; son interface de requêtes. |
| Grafana | Outil de visualisation : sources de données, tableaux de bord, panneaux, variables. |
| Tunnel SSH | Redirection d'un port à travers une connexion SSH chiffrée, pour joindre un service non exposé. |
Questions fréquentes#
Faut-il choisir entre Docker et Kubernetes ?#
Non. Docker fabrique les images et lance des conteneurs ; Kubernetes orchestre ces conteneurs sur un ou plusieurs serveurs : il les relance en cas de panne, répartit le trafic, les met à jour sans coupure et en ajoute quand la charge monte. On utilise en général Docker (ou un outil équivalent) pour construire les images, et Kubernetes pour les faire tourner.
Pourquoi faut-il stocker les sessions dans Redis quand on a plusieurs pods ?#
Par défaut, PHP enregistre les sessions dans des fichiers locaux. Avec plusieurs pods, deux requêtes d'un même visiteur peuvent arriver sur des pods différents : le second ne trouve pas la session, et le visiteur perd sa connexion ou son panier. Un Redis commun permet à tous les pods de lire la même session.
Quelle est la différence entre Prometheus et Grafana ?#
Prometheus collecte et stocke les mesures, les interroge avec le langage PromQL et évalue les règles d'alerte. Grafana ne stocke rien : il se connecte à des sources de données comme Prometheus et affiche les mesures dans des tableaux de bord. Les deux sont presque toujours utilisés ensemble.
VictoriaMetrics remplace-t-il Prometheus ?#
Il peut jouer le même rôle de collecte et de stockage : il lit le même format de mesures, accepte la même configuration de collecte, comprend PromQL et se branche dans Grafana comme une source Prometheus. Il est souvent choisi pour sa légèreté. Les exporters, les requêtes et Alertmanager restent les mêmes.
Comment accéder à Grafana sans l'exposer sur Internet ?#
Laissez son Service interne au cluster, puis créez un tunnel : kubectl port-forward relaie le Service vers un port local du serveur, et ssh -N -L relie ce port à votre poste à travers la connexion SSH chiffrée. Vous ouvrez ensuite Grafana à l'adresse http://127.0.0.1 suivie du port choisi.
Article publié le 06/11/2026 sous la signature de Jonathan Gutierrez, rédigé à partir des sources citées ci-dessus, puis relu avant publication. Une information vous semble inexacte ou datée ? Signalez-le nous, nous corrigeons.